对比顶级智能合约审计公司
1. CertiK
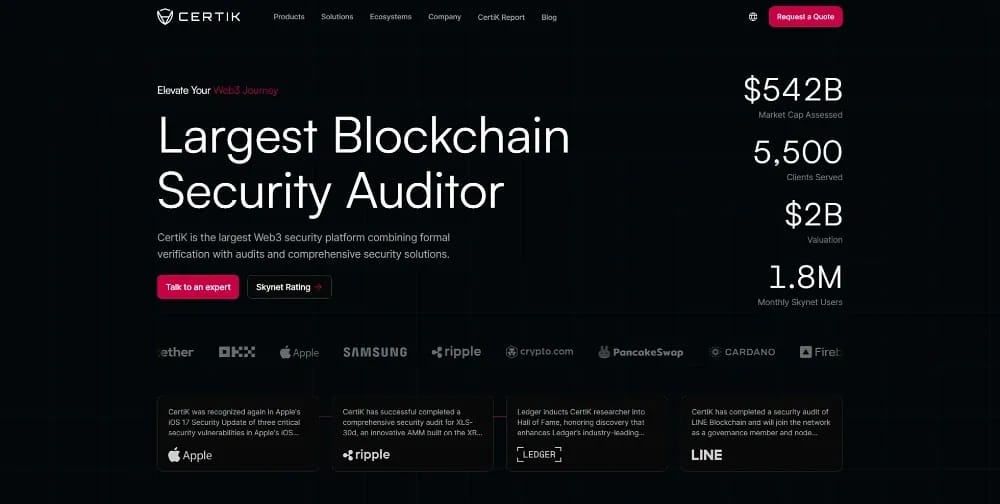
CertiK 依然是 Web3 安全领域最具代表性的品牌。它已在 20 多条区块链上完成了 5,500 多次审计,并披露了超过 115,000 个漏洞。其工程师将人工复核与形式化验证引擎相结合,在合约部署到主网之前,通过数学方法证明合约在所有可到达状态下的运行行为。
其核心差异化优势体现在审计报告出炉之后。Skynet 会对监控市值总计约 5,420 亿美元的线上协议进行持续评分,让团队能够了解升级、治理投票和集成如何随时间改变其风险状况。
CertiK 还发布行业标准的 Hack3d 安全报告,为潜在买家提供前所未有的当前攻击数据可见性。不过,规模大也有其弊端。rekt 排行榜记录了某曾接受过审计的客户遭遇的 2.16 亿美元 Gala Games 安全事件。
优点
- 形式化验证与审计后的 Skynet 持续评分相结合。
- 已发布的事件研究确保方法论与实时威胁保持一致。
- 庞大的客户基础证明了可重复的交付流程。
缺点
- 品牌知名度吸引了寻求合规打卡审计的项目。
- 部分曾接受过审查的客户出现在 rekt 排行榜上。
- 与精品替代方案相比,价格偏高。
2. Hacken
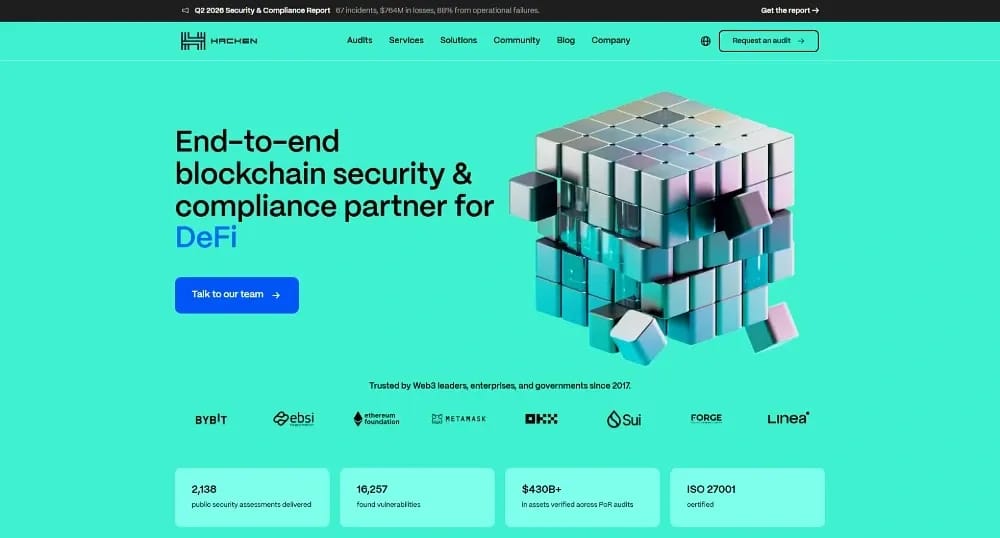
Hacken 通过 1,,600 多次客户合作保护了约 430 亿美元的数字资产,确立了其作为交易所和机构平台首选的地位。旗下的 HackenProof 漏洞赏金部门统筹着 45,000 名独立研究员。他们共同披露了 25,000 多个漏洞,并派发了 1,570 万美元的奖励。
监管合规性是 Hacken 在 2026 年最明显的优势。该机构将交付成果与 MiCA 和 DORA 要求相对接,生成合规就绪的文档,供欧洲实体直接提交给监管机构。其储备金证明鉴证还为 OKX 和 Bybit 等交易所验证了用户存款。
这种机构导向使 Hacken 特别适合 CASP 和托管机构,而不是实验性的 DeFi 原语。它的记录非常出色但并非无可挑剔:rekt 排行榜记录了其工程师先前审查过的一个协议曾发生过 780 万美元的 Warp Finance 利用事件。
优点
- 与合规性相契合的报告直接满足 MiCA 和 DORA 的义务。
- 庞大的漏洞赏金网络将覆盖范围延伸至审计窗口之外。
- 储备金证明核验建立了交易所用户的信心。
缺点
- 宏观总体指标很难直接映射到单个链上。
- 企业级定位对于小型 DeFi 团队而言可能显得过于沉重。
- 历史上曾发生过一次审计后的安全事件并记录在 rekt 排行榜上。
3. Hashlock
Hashlock 是澳大利亚领先的智能合约审计机构,已完成 500 多个项目审查,保障了约 40 亿美元资产的安全。业务重点是以太坊、Solana 和 Polygon 上的逐行人工检查。其背后依托专属的安全评级系统,并承诺提供三小时以内的响应时间。
最值得注意的是 Hashlock 声称,没有一家经过全面审计的客户遭遇过成功的攻击,目前的公开 rekt 排行榜也印证了这一点。其评测高度关注业务逻辑与激励设计。这些恰恰是自动化扫描工具经常漏掉、而攻击者持续瞄准的漏洞类别。
安全服务在初次评测之后也并未停止。Hashlock 的威胁监控与链上监控会密切关注已部署合约的异常情况。独立的代币经济学评估则会寻找设计不良的激励机制,因为即使底层代码在技术上完全正确,这些机制也可能制造出经济层面的攻击路径。
优点
- 在经过全面审计的客户项目中,零记录在案的攻击事件。
- 代币经济学评测可捕捉代码正确性之外的经济风险。
- 快速的评估响应适合上线时间紧迫的团队。
缺点
- 全球业务足迹小于美国和欧洲的竞争对手。
- 其内部工具栈的公开文档有限。
- 监控警报仍然需要客户端的升级处理程序。
4. Trail of Bits
Trail of Bits 将区块链项目视作系统安全研究公司来进行对接。其评测不仅限于智能合约,还会延伸至链下 keeper、中继器以及管理工具,现代攻击者正日益将这些全部作为攻击目标。自 2012 年运营以来,该机构带来了极少数 Web3 原生竞争对手所能比拟的密码学和软件保障专业知识。
行业中的大部分核心安全工具均出自 Trail of Bits。该机构构建并维护着 Slither 静态分析器以及 Echidna 和 Medusa 模糊测试工具,其顾问在进行人工评测的同时也会使用这些工具。这种以研究为主导的方法使其成为新型架构、zero-knowledge 系统和共识关键基础设施的首选。
其项目的推进通常比同质化审计更深入、更缓慢,这使得它们比直接的代币发行更适合复杂的协议。精英研究仍然有其局限性。rekt 排行榜记录了 Raft 发生的一起 330 万美元攻击事件,而 Trail of Bits 此前曾对该项目进行过审查。
优点
- 在密码学和链下基础设施评测方面具有无与伦比的深度。
- 维护行业标准的开源分析工具。
- 在主要 Web3 审计机构中拥有最长的运营历史。
缺点
- 项目风格较为缓慢且资源消耗较大。
- 对于简单、范围小的代币审计而言,定价过高。
- 不以资产保护金额的亮眼数据作为营销对比。
5. Cyfrin
由 Patrick Collins 于 2023 年创立的 Cyfrin 已发展成为顶级审计机构,同时将安全工作与开发者教育相结合。该公司已保障了约 400 亿美元的资产。其免费的 Updraft 平台已培训了超过 10万名学员掌握 Solidity、Vyper 以及安全研究基础知识。
这种教育生态系统反哺了该机构的审计工作。CodeHawks(其竞技平台)和 Solodit 漏洞数据库不断让研究人员接触到新的攻击模式。包括 ZKsync、Chainlink 和 Starknet 在内的客户会收到透明度异常高的报告,通常还会辅以公开的视频通关解析。
Cyfrin 特别适合那些希望审计具有协作性、并让自己的开发人员在流程结束后比开始时更具能力的团队。虽然它的历史比老牌竞争对手短,但目前没有任何经过全面审计的 Cyfrin 项目出现在 rekt 排行榜上。
优点
- 教育至上的模式在项目合作期间提升了客户团队的技能水平。
- 在已完成的私密评测中拥有干净的审计后记录。
- 免费工具和 Solodit 数据库惠及更广泛的生态系统。
缺点
- 运营历史比运营达十年的竞争对手短。
- 竞技审计对客户内部的分类筛选能力有较高要求。
- 公开案例研究的深度因合作类型而异。
6. Sherlock
Sherlock 已完成 1,000 多次审计,并通过基于研究人员绩效数据(而非固定的内部团队)的模型保护了超过 2,500 亿美元的 TVL。其网络包含 11,000 多名研究人员,并在借贷、跨链桥或跨链消息传递等领域拥有经过验证的专家,可与每个代码库进行匹配。
审计竞赛可以同时将数百名独立研究人员聚集在一个范围内。高级负责人负责主导流程,而评审流程则处理重复的发现。重大合作包括 Ethereum Foundation 的 200 万美元 Fusaka 压力测试以及 Ripple 的 550,000 美元 XRP Ledger 竞赛。
Sherlock 也是唯一一家提供财务问责制的主要审计机构,当漏掉受保护的漏洞时,会向协议赔偿高达 200 万美元。rekt 排行榜将 1.97 亿美元的 Euler 漏洞利用归咎于 Sherlock。在该案例中,该公司显著地根据其承保范围支付了索赔。
优点
- 按绩效排名的团队配备将专家与每个代码库相匹配。
- 可选的漏洞利用承保范围使审计机构的激励措施与客户保持一致。
- 竞赛模型为每个范围提供数百名对抗性审阅者。
缺点
- 竞赛发现需要严格的内部修复管理。
- Euler 事件仍然是 rekt 上记录的最大审计损失。
- 承保条款包含团队必须仔细阅读的范围限制。
7. Spearbit (Cantina)
Spearbit 是 Cantina 平台背后的精英研究人员集体。这两个品牌于 2025 年 5 月合并为一个安全技术栈。其联合网络包括 9,000 多名研究人员,已保护了超过 1,000 亿美元的链上价值,并为 Coinbase、Uniswap 和 Aave 等客户提供服务。
对于私人合作,Spearbit 组建了由首席安全研究人员组成的精选团队,以处理业内一些风险最高的评审。同时,Cantina 的公开竞赛已在 200 多个协议中分发了 4,670 万美元。标志性竞赛包括 Uniswap v4 的 235 万美元竞赛以及 Ethereum Foundation 的 200 万美元 Pectra 硬分叉评审。
2026 年,该平台正朝着全生命周期安全方向发展。AI 原生分析、托管漏洞赏金和持续覆盖正被叠加到点对点评审中。其公开记录依然强劲,因范围争议而引发的 1,200 万美元 Cork Protocol 事件是批评者引用的主要瑕疵。
优点
- 能够接触到可以说是最深厚的精英研究人员人才库。
- 标志性竞赛展示了旗舰代码库的能力。
- 持续覆盖将保护范围延伸至发布之后。
缺点
- 高级定价针对资金充足的协议。
- 市场模型要求客户评估研究人员的契合度。
- 一起有争议的审计后事件引发了反复批评。
8. Halborn
Halborn 是一家攻击性安全公司,其白帽黑客将合作视为实战攻击模拟。合同审查只是其工作的一部分。团队还针对协议周围的 Web 应用程序、API 和内部流程进行渗透测试、钓鱼活动和社工演练。
该公司报告保护资产超过 1 万亿美元。其客户包括 Polygon 和 Avalanche 等主要网络,以及进军数字资产领域的银行和企业。这种更广泛的攻击面理念与 2026 年的威胁数据相符,因为钱包遭泄露和社交工程现在已经超过纯代码漏洞利用,成为造成损失的主要原因。
SOC 2 认证与对机构安全框架的契合有助于简化受监管实体的采购流程。Halborn 的 rekt 排行榜条目包括 MonoX(损失 3140 万美元)和 Seneca Protocol(损失 640 万美元),这两者此前均由其团队进行过评估。
优点
- 攻击面覆盖范围远远超出了合约代码。
- 认证简化了受监管机构的采购流程。
- 攻击性思维真实反映了实际黑客的运作方式。
缺点
- 企业级规模增加了项目对接的协调成本。
- 核心指标并未按链拆分价值。
- 两个此前评估过的协议出现在 rekt 排行榜上。
9. OpenZeppelin
OpenZeppelin 维护着构成大部分 EVM 生态系统底层基础的合约库,因此其审计员对许多代码库继承的模式拥有极高的熟悉度。该机构已对跨越 30 多个链的数百万行代码进行了审查,并为 Compound 和 Aave 等协议保护了数百亿美元的 TVL。
它与 Ethereum Foundation 在协议级安全工作上的合作伙伴关系巩固了 OpenZeppelin 作为核心基础设施主流选择的地位。审计将深入的手动审查与部署验证相结合。这一额外的步骤减少了配置错误和审计后的 rent,这两者都是即使在获得干净报告后真实世界事件的常见原因。
需求是主要的限制因素。在繁忙的发布期,小型团队的排期可能会 Stretch。rekt 排行榜还记录了一起涉及先前审查代码的 600 万美元 Audius 事件,这表明为什么规范的实现在部署后仍然需要持续监控。
优点
- 编写代码库的经验带来了无与伦比的 EVM 模式专业知识。
- 部署验证减少了审计后的配置 rent。
- 与 Ethereum Foundation 的合作标志着机构的信任。
缺点
- 在繁忙的发布季,排期队列会变长。
- 最佳结果需要强大的客户端工程准备。
- EVM 重点限制了对 Non-EVM 架构的适应性。
10. Quantstamp
Quantstamp 自 2017 年以来已通过 1,100 多次业务保障了超过 2,000 亿美元的价值,使其成为运营时间最长的专注 Web3 审计机构之一。其覆盖范围真正做到了跨链,横跨 Ethereum、Solana、Flow 和 Cardano。该机构还审计了共识关键型软件,包括 Prysm 和 Teku Ethereum 客户端。
多次获得 Ethereum Foundation 用于扩展研究的资助增强了 Quantstamp 在协议层面的公信力。其报告以对交易排序依赖性和时间戳操纵等微妙风险的详细处理而闻名。这种严谨性吸引了需要能够经受投资者和监管机构审查文档的机构 DeFi 团队。
悠久的运营历史也留下了更多发生事件的机会。rekt 排行榜记录了此前审计过的 Alpha Finance 和 Rari Capital 遭受的漏洞利用,总计超过 4700 万美元。Quantstamp 广泛的公开报告档案至少允许潜在买家直接评估其当前的方针。
优点
- 协议级经验包括 Ethereum 共识客户端。
- 广泛的公开报告档案支持买家尽职调查。
- 跨链覆盖范围横跨 EVM 和 Non-EVM 生态系统。
缺点
- 对于特殊设计,标准化流程可能会显得有些泛泛。
- rekt 排行榜上记录了两次重大的审计后事件。
- 客户必须积极评估管理和部署风险。
简明智能合约解析
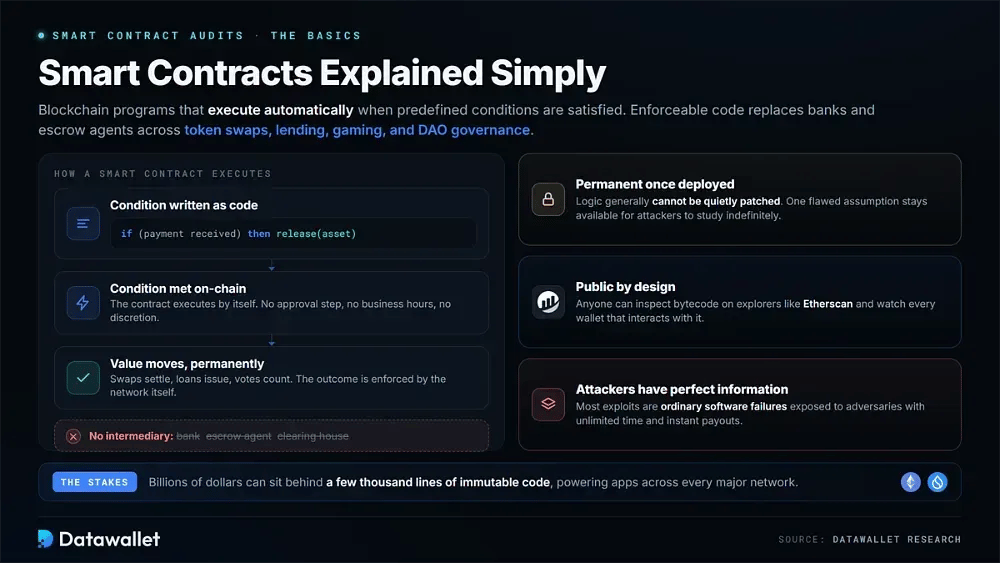
智能合约是基于区块链的程序,能够在满足预定条件时自动执行。可执行代码取代了银行和托管代理等中介机构。这些合约为各大网络上的代币兑换、借贷市场、游戏经济、DAO 治理以及其他应用提供动力。
永久性是其鲜明特征之一。一旦部署,合约逻辑通常无法像传统软件那样悄悄修补。一个有缺陷的假设可能会让攻击者无限期地进行研究,而数十亿美元的资金可能仅仅存放在几千行不可变的代码后面。
代码也是公开的。任何人都可以通过 Etherscan 等区块浏览器检查合约字节码,并观察与之交互的加密钱包地址。因此,攻击者在掌握完全信息的情况下行动。大多数攻击都是普通的软件故障,暴露给拥有无限时间进行调查并能获得即时赔付的对手。
什么是智能合约审计?
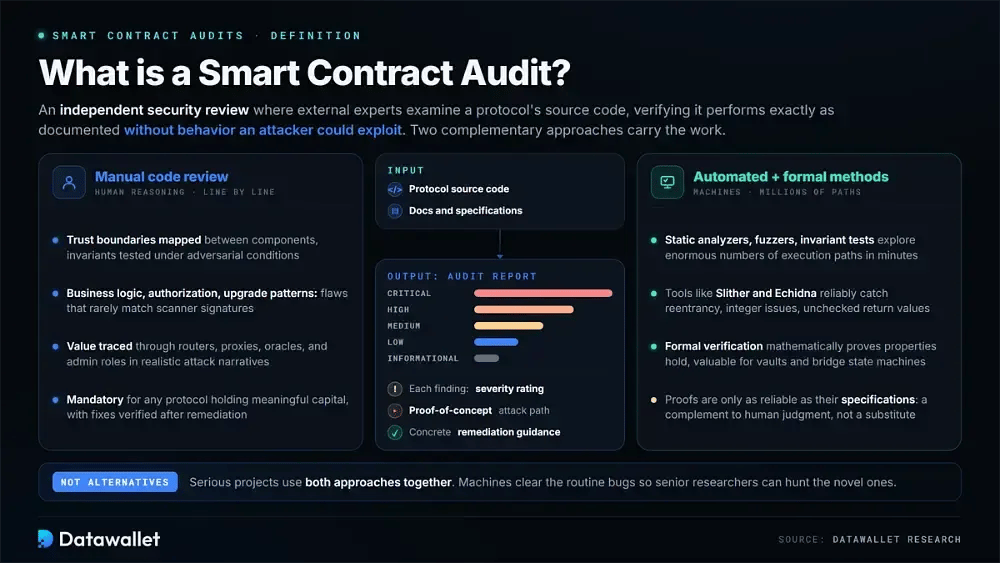
智能合约审计是一项独立的安全性审查,在此审查中,外部专家会在部署前后检查协议的源代码。其目的是验证合约是否完全按照其文档承诺的那样执行,而不会暴露攻击者可以利用的行为。
每个发现都记录有严重性评级和概念验证攻击路径,随后是具体的修复指导。行业主要依赖两种互补的方法。严肃的项目通常会同时采用这两种方法,而不是将它们视为替代方案。
1. 手动代码审查审计
人工审计依赖于人类的推理。高级研究人员逐行阅读代码库,并绘制组件之间的信任边界。他们还会测试既定的不变量是否能在对抗条件下存活。商业逻辑缺陷、被破坏的授权路径以及危险的升级模式通常会在这里显现,因为它们很少与扫描器特征相匹配。
严格的人工审查不仅关注单个合约,还关注模块之间的交互方式。审查人员通过路由器、代理、预言机和管理角色追踪价值,然后模拟可能包含经济压力场景的真实攻击叙事。一旦修复完成,他们就会验证修复效果。这种深度使得人工审查成为任何持有重要资本的协议的必经程序。
2. 自动化和形式化方法审计
自动化分析可以通过使用静态分析器、模糊测试器和不变量测试,在几分钟内探索数量庞大的执行路径。Slither 和 Echidna 等工具可以可靠地识别重入、整数问题和未检查的返回值。开发人员可以在花费昂贵的人工审查时间之前,尽早消除这些常见错误。
形式化验证则更进一步。它在数学上证明了指定的属性在定义的模型下成立,这对于金库会计或跨链桥状态机等高风险组件尤其有价值。然而,证明的好坏取决于其背后的规范。因此,形式方法补充了经验丰富的人类判断,而不是取代它。
如何审计智能合约
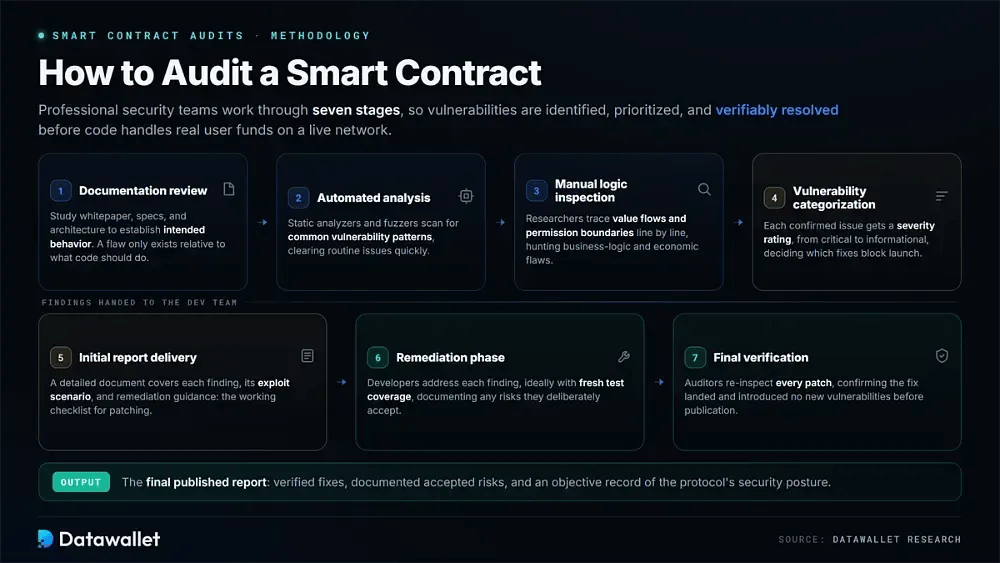
严谨的审计方法有助于确保在代码开始在实时网络上处理真实用户资金之前,识别、确定优先级并切实解决漏洞。
专业的安全团队将经历以下七个阶段:
- 文档审查:审计员研究白皮书、规范和架构图,以确定系统的预期行为方式。缺陷只能相对于代码应该做什么来定义。
- 自动化分析:静态分析器和模糊测试器扫描代码库中的常见漏洞模式,快速清除常规问题,以便高级审查人员能够专注于机器无法检测的问题。
- 人工逻辑检查:经验丰富的研究人员逐行检查代码,并沿着权限边界追踪价值流,寻找特定于协议设计的商业逻辑和经济缺陷。
- 漏洞分类:每个确认的问题都会收到从严重到信息级别的严重性评级。这为开发人员决定在发布前必须完成哪些修复提供了客观依据。
- 初始报告交付:团队会收到一份详细的文档,涵盖每个发现、其攻击场景以及具体的修复指导。该报告成为修补过程中的工作清单。
- 修复阶段:开发人员解决每个发现,最好是添加新的测试覆盖率,同时在团队刻意选择不改变行为时记录接受的风险。
- 最终验证:审计员再次检查每一个补丁,以确保问题确实得到解决,并且在发布最终报告之前,修复没有引入新的漏洞。
2026 年智能合约安全趋势
2026 年的威胁形势与许多审计方法最初设计时的环境有很大不同。攻击者已转向更上游的环节,而审计人员正在利用人工智能迅速对其自身工具进行工业化改造。
这些变化需要影响参与范围。围绕 2022 年左右威胁设计的审查可能无法检查今天正在耗尽协议资金的攻击向量。
攻击者正在超越代码本身
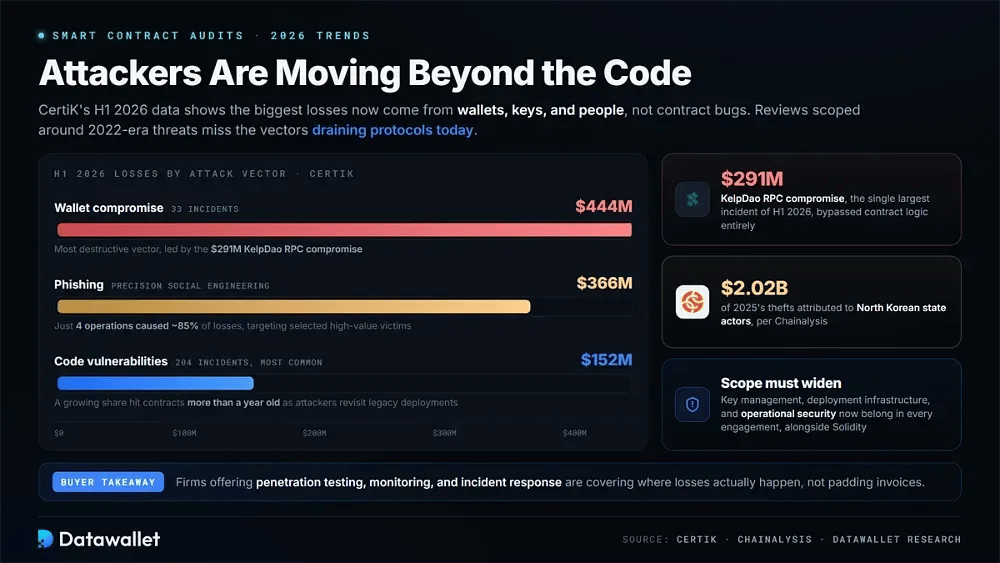
CertiK 2026 年上半年的数据显示,钱包遭入侵是最具破坏性的攻击向量,在仅 33 起事件中造成了 4.44 亿美元的损失。该总额主要是由 2.91 亿美元的 KelpDao RPC 妥协事件引起的。钓鱼攻击造成了另外 3.66 亿美元的损失,其中四起精准的社会工程学行动针对精心挑选的高价值受害者,造成了大约 85% 的损失。
代码漏洞依然是最常见的类别,在 204 起事件中出现,然而造成的损失相对较少,为 1.52 亿美元。随着攻击者系统性地重新将目标对准历史部署项目,运行超过一年的智能合约所占的比例正在上升。同时,Chainalysis 认为 2025 年 20.2 亿美元的被盗资金源自朝鲜国家黑客。
如今,审计范围除了解决运营安全和 Solidity 之外,还需要涵盖密钥管理与部署基础设施。提供渗透测试、监控和应急响应的公司正在解决实际发生损失的地方,而不是仅仅在发票上增加名目。买家在比较合作提案时应考虑到这一转变。
AI 进入审计技术栈
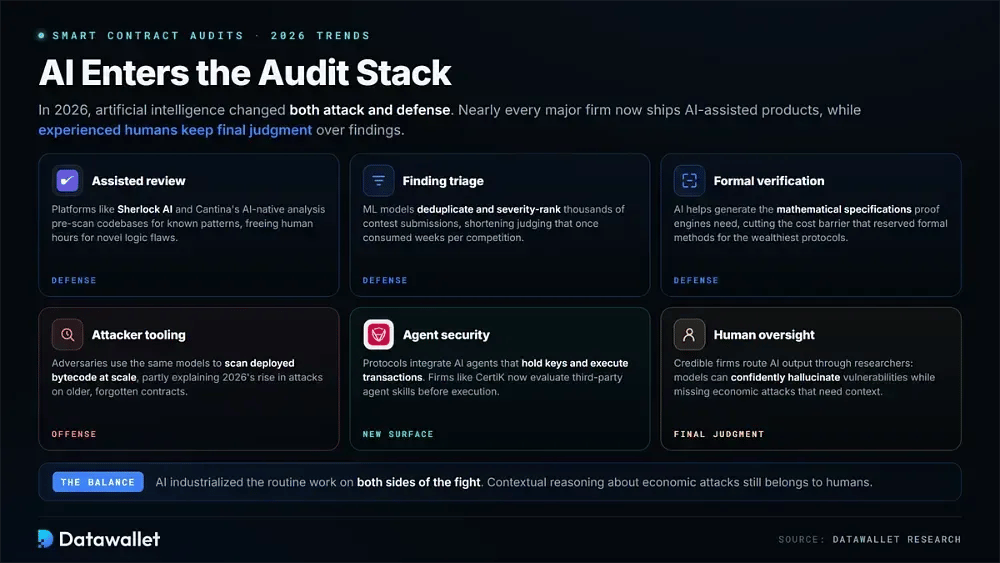
人工智能在 2026 年改变了攻击与防御双方。几乎所有主流公司现在都提供 AI 辅助产品,同时也坚持认为经验丰富的人类研究人员对审计结果拥有最终决定权。
今年 AI 正在以以下方式改变智能合约安全:
- 辅助复查:像 Sherlock AI 和 Cantina 的 AI 原生分析等平台会预先扫描代码库中的已知模式,以便人类研究人员能够将有限的复查时间投入到新颖的逻辑漏洞中。
- 漏洞分级结果: Machine learning models automatically deduplicate and severity-rank thousands of contest submissions, shortening judging timelines that once consumed weeks of senior researcher attention for each competition.
- 形式化验证:AI 协助生成证明引擎所需的数学规范,从而降低了将形式化方法局限于资金最雄厚协议的历史成本门槛。
- 攻击者工具:攻击者使用相同的模型大规模扫描已部署的字节码以寻找可利用的模式,这在一定程度上解释了 2026 年针对较旧、已被遗忘合约的攻击增加的原因。
- 智能体安全:协议越来越多地集成持有密钥并执行交易的 AI 智能体。诸如 CertiK 等公司现在提供专门的产品,在执行前评估第三方智能体的技能。
- 人工监督:可靠的公司仍然会将 AI 生成的输出交给经验丰富的研究人员进行审核,因为模型在自信地产生漏洞幻觉的同时,可能会遗漏依赖于真实上下文推理的经济攻击。
如何选择智能合约审计机构
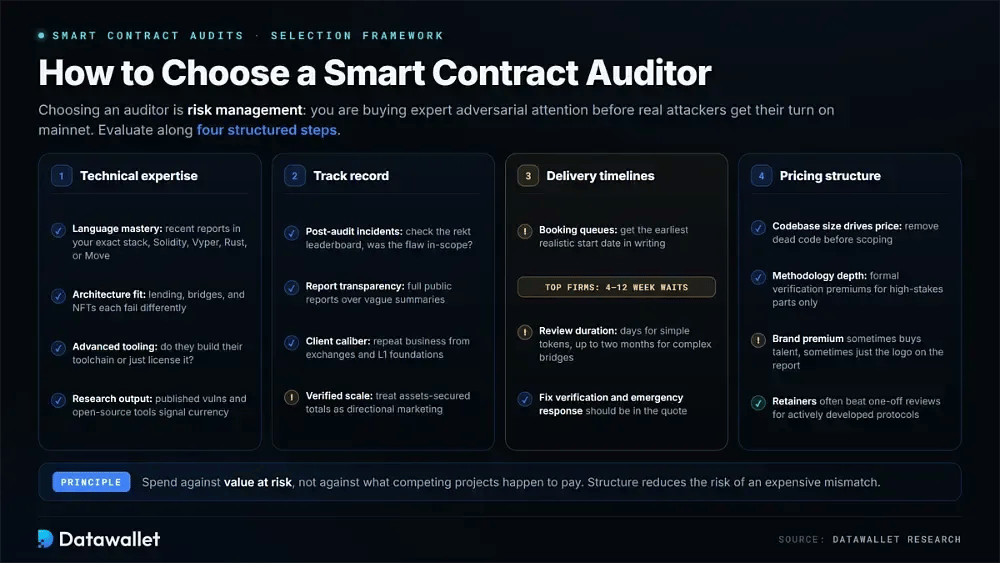
选择审计机构本质上是一项风险管理活动。在真正的攻击者在主网获得机会之前,你购买的是专家级的对抗性关注。以结构化的方式评估专业知识、历史业绩、时间表和成本,可以降低发生代价高昂的不匹配风险。
第一步:评估技术专长
将展示出的经验与你的具体技术栈相匹配。即使是极佳的 Solidity 审核人员也可能会忽视 Rust、Cairo 或 Move 代码库中的关键问题。
在此评估期间需要考虑的关键因素:
- 语言精通度:确认对方在你的特定语言(无论是 Solidity、Vyper、Rust 还是 Move)方面拥有深厚且近期的经验,并寻找该生态系统内已发布的报告。
- 架构适配性:验证团队是否审计过同类设计。借贷市场、cross-chain bridge和 NFT 基础设施各自面临不同的故障模式。
- 高级工具链:询问该团队常规使用哪些模糊测试工具、静态分析器和形式化验证引擎,以及它是自主构建还是仅仅获得工具链的授权。
- 研究成果:优先选择发布漏洞研究并贡献开源工具的机构。随着两次审计之间攻击技术的不断变化,活跃的研究人员更有可能保持领先。
步骤 2:分析安全履历
如果没有独立验证,营销指标就没什么分量。在建立候选名单之前,请将每项声明与公开的审计报告和中立的事件数据库进行比对。
评估以下指标以衡量其可靠性:
- 审计后事件:在 rekt 排行榜中搜索涉及先前已审计客户的攻击事件。然后确定该漏洞是在审计范围内、范围之外,还是在评审后添加的。
- 报告透明度:优先考虑发布完整报告的机构。隐藏的发现和模糊的摘要使得实际的评审深度难以判断。
- 客户水准:寻找来自交易所、L1 基金会和蓝筹协议等成熟买家的回头客业务,因为知情的回头客能够提供有意义的质量信号。
- 已核实规模:将资产担保总额视为方向性营销指标。更应看重可统计的事实,例如已发布的报告、具名客户以及研究员名册。
步骤 3:评估交付时间表
上线时间表本身就能决定入围名单。顶级的私密审计公司可能会被预约数周甚至数月,而竞争平台有时几天内就能开始。
在排期和速度方面,请考虑以下几点:
- 排队预约:以书面形式索取最早的实际开始日期。在旺季,知名机构通常会报出四到十二周的等待期。
- 评审持续时间:将预期时间表与范围相匹配,简单代币只需几天,而复杂的桥或新颖的架构则可能需要长达两个月。
- 修复验证:检查报价是否包含对补丁的重新审查。缺乏整改验证的审计会漏掉流程中最危险的部分。
- 应急响应:确定是否为线上安全事件或紧急补丁提供快速支持,最好有合同约定的响应时间承诺。
步骤 4:比较定价结构
审计费用应体现面临的风险价值,而不是由竞争项目凑巧支付的费用来决定。了解报价的驱动因素也有助于巧妙地协商范围,而不是盲目接受一个数字。
影响总成本的因素包括:
- 代码库规模:定价主要基于源代码行数和架构复杂度。因此,在界定范围前清理冗余代码可以直接减少账单金额。
- 方法论深度:形式化验证和多研究员团队的成本高于标准审查。这些溢价主要针对保护大量或不可逆资产的组件才是合理的。
- 品牌溢价:知名机构的收费远高于新兴精品团队。有时这种溢价买来的是更深厚的人才实力,而在其他情况下,买到的不过是报告上的标志而已。
- 持续 retainer:持续监控、赏金管理和定期重新审计将安全性转化为运营成本。对于积极开发中的协议,这种模式通常优于一次性审查。
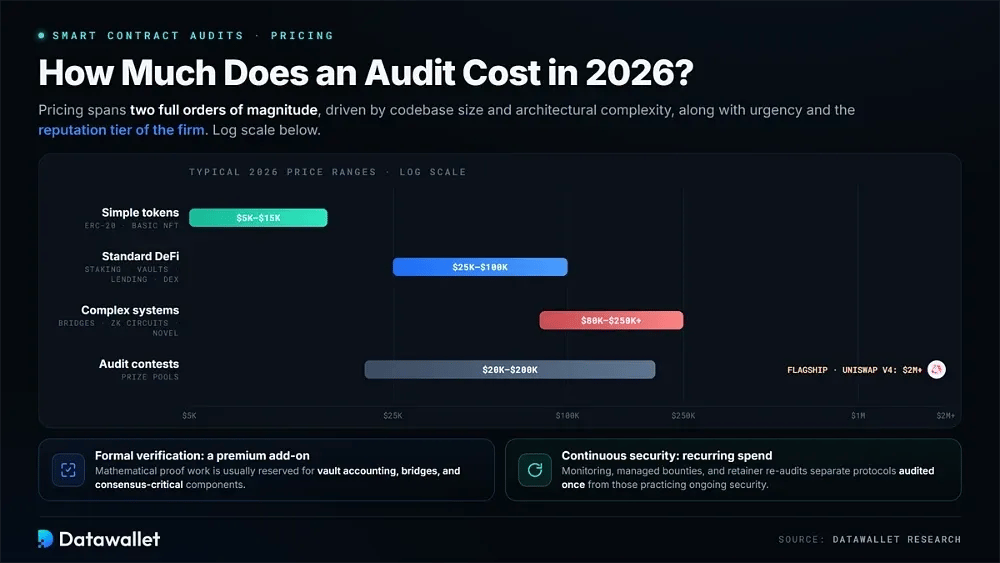
2026 年智能合约审计费用是多少?
2026 年智能合约审计的定价跨越了两个数量级。报价随代码库规模和架构复杂度而异,同时还取决于紧迫性以及所聘机构的声誉等级。
2026 年的典型价格区间细分如下:
- 简单代币:标准的 ERC-20 或基础 NFT 合约在精品机构的收费一般为 5,000 至 15,000 美元,通常在一个工作周内即可完成。
- 标准 DeFi:staking 系统、金库和中等复杂度的协议通常成本在 25,000 至 100,000 美元之间。大多数严肃的借贷或 DEX 项目都落在这个范围内。
- 复杂系统:跨链桥、zero-knowledge 电路以及新颖的架构通常达到 80,000 至 250,000 美元以上,这反映了这些攻击面真正需要的数周工作量和多位研究人员。
- 审计竞赛:竞技平台的奖金池大约在 20,000 至 200,000 美元之间,而像 Uniswap v4 这样的旗舰级竞赛奖金已超过 200 万美元。
- 形式化验证:数学证明工作为标准审查定价增加了显着的溢价,通常保留用于金库记账、跨链桥和共识关键组件。
- 持续安全:监控订阅、托管赏金和 retainer 重新审计会带来经常性成本。这些服务正日益将仅接受过一次审计的协议与那些践行持续安全的协议区分开来。
常见的智能合约漏洞
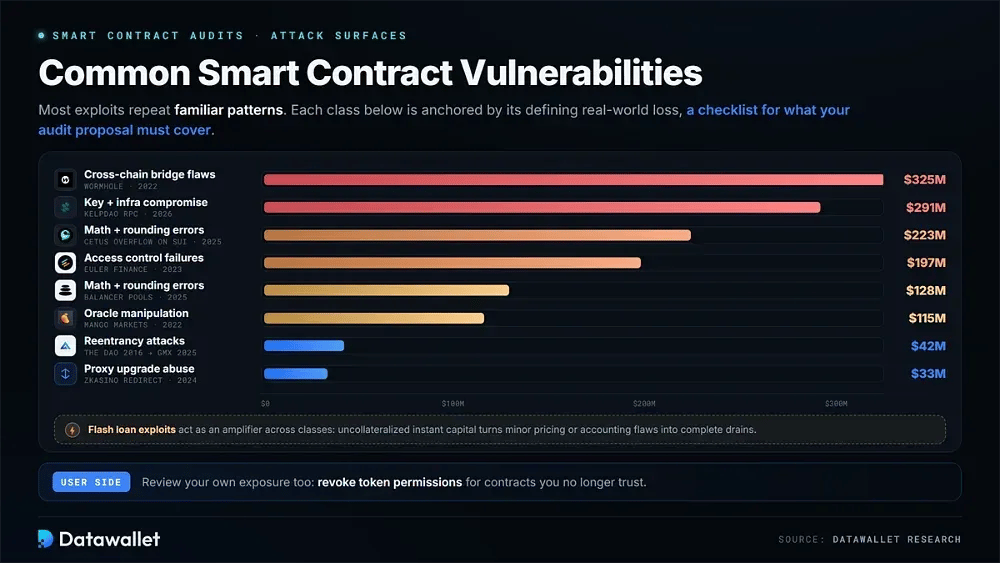
大多数漏洞利用都重复着熟悉的模式。理解这些类别有助于开发者编写更具防御性的代码,同时也为买家提供了一种检查审计提案是否涵盖正确攻击面的方法。
以下是 2026 年破坏力最大的漏洞类别:
- 重入攻击:在执行期间重新进入合约的外部调用仍在不断造成受害者,从 The DAO 一直到 GMX 在 2025 年遭受的 4200 万美元漏洞利用。
- 访问控制失败:缺失或配置错误的权限可能允许攻击者调用特权函数。这是导致 1.97 亿美元 Euler Finance 漏洞利用以及无数较小规模资金被盗的因素之一。
- 数学与舍入错误:池算术中的精度缺陷导致了 Balancer 在 2025 年底损失 1.28 亿美元,以及 Sui 上 2.23 亿美元的 Cetus 溢出漏洞利用。
- 预言机操纵:通过扭曲价格feed,攻击者可以针对被人为抬高的抵押品进行借贷。这是 Mango Markets 被盗 1.15 亿美元及许多后续攻击背后的机制。
- 闪电贷漏洞利用:无抵押的即时贷款使攻击者能够在单笔交易中获得庞大的资金,从而将微小的定价或记账缺陷放大为完全的资金洗劫。
- 代理升级滥用:保护薄弱的升级路径可能会促成恶意的逻辑 swap,正如 ZKasino 通过未经授权的更改转移了 3300 万美元的用户存款时所发生的那样。
- 私钥与基础设施遭到入侵:被盗的签名私钥和遭到劫持的 RPC 端点造成了 2026 年最大规模的损失,其中包括 KelpDao 价值 2.91 亿美元的安全事件,攻击者完全绕过了合约逻辑。
- 跨链桥漏洞:签名验证漏洞和消息传递漏洞使跨链桥依然是最常遭受攻击的目标之一。Wormhole 价值 3.25 亿美元的黑客攻击事件仍然是这方面的典型代表。
用户还需要定期评估自身的风险敞口。一个实用的切入点是学习如何为不再信任的合约revoke token permissions。
最后总结
对于区块链团队而言,选择安全合作伙伴依然是所有决策中最具leverage的决定之一。任何一个被遗漏的漏洞都可能抹杀其他所有增长努力所取得的成果。
没有任何审计能够保证绝对安全。2026 年的数据还表明,攻击者正日益完全绕过合约代码。即便如此,知名机构开展的分层审查仍能大幅减少可预防的故障。
协议用户在评估项目时也可以采用同一标准。多次独立审计、活跃的漏洞赏金计划以及持续监控,比单一且过时的 PDF 报告更具说服力。
我们的评测方法
我们对在 2026 年 8 月保持活跃并接受新业务委托的智能合约审计公司进行了评测。所有声明均通过第一手资料而非营销页面进行了核实。该排名基于六项标准:
- Trust score:Datawallet 的满分为 5 分的评分体系,综合权衡了已核实的审计产出、研究人员的专业深度、报告的透明度,以及各机构如何处理先前评测过的客户所发生的安全事件。
- 审计后历史记录:我们将每家机构与 rekt.news 排行榜进行了交叉比对。我们记录了每起归属明确的安全事件,随后审查了最初的审计范围,以确定被攻击的代码是否确实在审计范围内。
- 已核实指标:审计数量、保障资产规模以及研究人员数量均来源于各公司官方网站及 2026 年 8 月发布的报告。无法独立确认的数据均已被标出。
- 服务范围:我们审查了每项业务委托所包含的内容,涵盖人工审查深度、形式化验证、监控、漏洞赏金管理、事件响应以及修复后的漏洞验证。
- 生态系统覆盖范围:我们通过已发布的报告而非宽泛的宣传来核查其对区块链和编程语言的支持情况。机构在 Solana、Move 或 zk 系统方面的真实专业能力应当在其公开成果中有所体现。
- 市场相关性:我们评估了 2026 年的需求信号,例如以太坊基金会重磅硬分叉审查、MiCA 监管下的交易所合规工作,以及对竞赛和 AI 辅助模型的采用情况。
研究工作于 2026 年 9 月初结束,各机构的活跃状态在发布日期当天进行了重新核实。我们的编辑方法论详细阐述了每项声明的核实过程。