Che cos'è il machine learning zero-knowledge (zkML)?
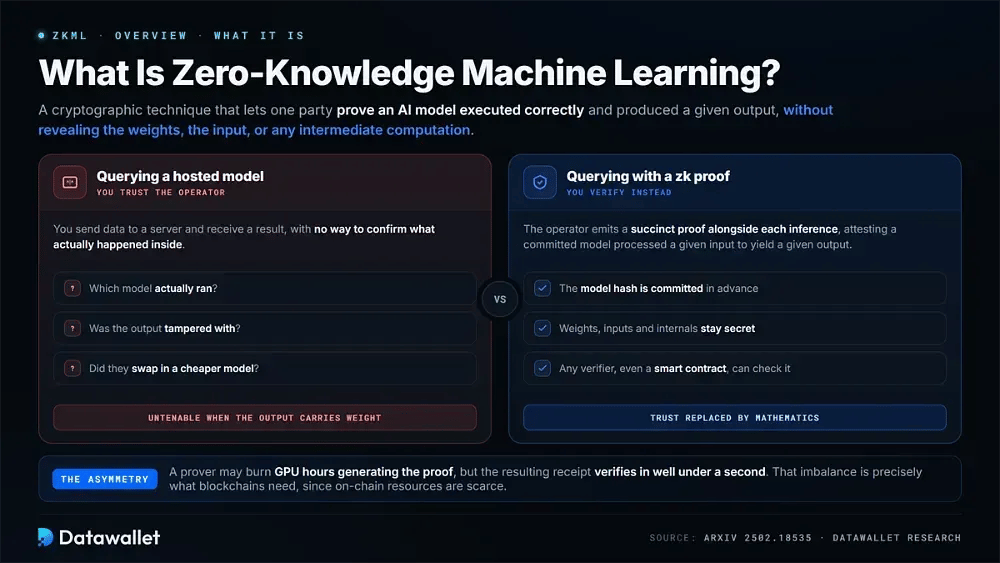
Il machine learning zero-knowledge è una tecnica crittografica che consente a una parte di dimostrare che un modello di IA è stato eseguito correttamente e ha prodotto un determinato output, senza rivelare i pesi del modello, i dati di input o qualsiasi calcolo intermedio. Trasforma un'affermazione di correttezza in un oggetto matematico che chiunque può verificare.
Il problema che risolve è strutturale. Quando interroghi un modello ospitato, invii dati a un server e ricevi un risultato senza alcun modo di confermare quale modello sia stato effettivamente eseguito, se l'output sia stato manomesso o se il fornitore abbia sostituito il modello con uno più economico. Ti affidi completamente a esso, il che è insostenibile quando l'output ha un peso finanziario, medico o legale.
zkML sostituisce questa fiducia con la verifica. L'operatore del modello genera una prova crittografica succinta per ogni inferenza, attestando che un modello specifico, già vincolato, ha elaborato un input specifico per produrre un output specifico. La prova non contiene alcun segreto, eppure qualsiasi terza parte, incluso uno smart contract, può convalidarla in millisecondi.
L'asimmetria è ciò che lo rende praticabile. Il calcolo può essere costoso mentre la verifica resta economica: un prover può impiegare ore di GPU per generare la prova, ma la ricevuta si verifica in meno di 1 secondo. Questo squilibrio è esattamente ciò che serve alle blockchain, poiché le risorse on-chain sono scarse e consumare un output di IA off-chain richiede altrimenti di fidarsi di un oracolo.
Come funziona zkML?
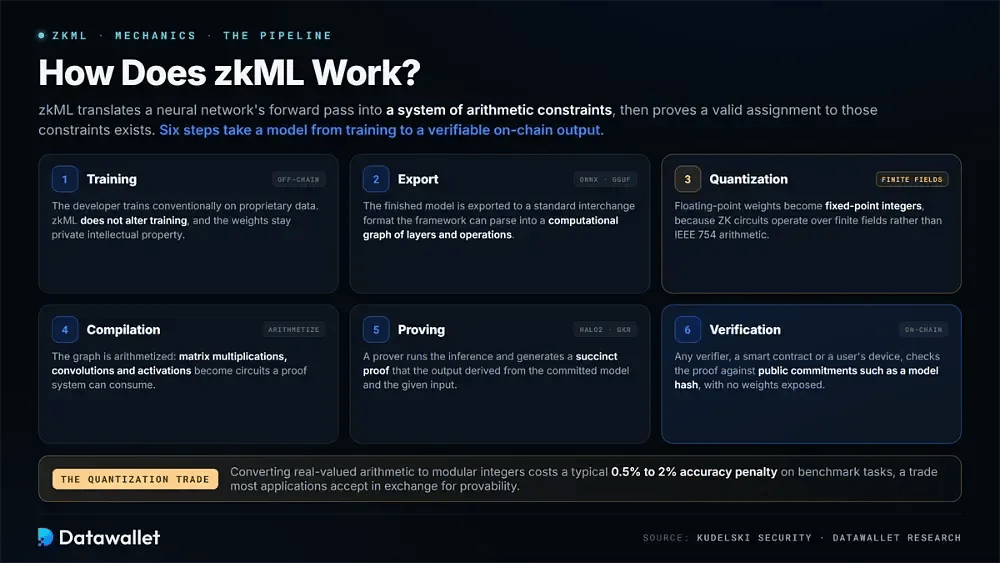
zkML traduce il passaggio in avanti di una rete neurale in un sistema di vincoli aritmetici, quindi dimostra che esiste un'assegnazione valida per tali vincoli.
Ecco come un modello passa dall'addestramento a un risultato on-chain verificabile:
- Addestramento: lo sviluppatore addestra un modello in modo convenzionale, off-chain, usando dati e tecniche proprietari. zkML non modifica l'addestramento in sé, e i pesi risultanti restano proprietà intellettuale riservata.
- Esportazione: il modello finito viene esportato in un formato di interscambio standard, tipicamente ONNX o GGUF, che il framework di prova può analizzare in un grafo computazionale di livelli e operazioni.
- Quantizzazione: i pesi in virgola mobile vengono approssimati come interi in virgola fissa, poiché i circuiti ZK operano su campi finiti anziché con l'aritmetica IEEE 754, un passaggio che costa una piccola quantità di accuratezza.
- Compilazione: il framework aritmetizza il grafo, convertendo moltiplicazioni di matrici, convoluzioni e attivazioni non lineari in circuiti o sistemi di vincoli che un sistema di prove può elaborare.
- Dimostrazione: Un prover esegue l'inferenza e genera una prova sintetica che attesta l'output derivato dal modello impegnato e dall'input fornito, usando sistemi come Halo2, GKR o argomenti basati su lookup.
- Verifica: qualsiasi verificatore, uno smart contract, un revisore o il dispositivo di un utente controlla la prova zero-knowledge rispetto a impegni pubblici come l'hash di un modello, confermandone la correttezza senza esporre pesi o dati grezzi.
La fase di quantizzazione merita attenzione perché è il punto in cui il rigore crittografico incontra la realtà del machine learning. Convertire l'aritmetica a valori reali in aritmetica intera modulare comporta una tipica perdita di accuratezza di circa 0,5 a 2% nei test di benchmark, un compromesso che la maggior parte delle applicazioni accetta in cambio della verificabilità.
Perché la prova è così costosa
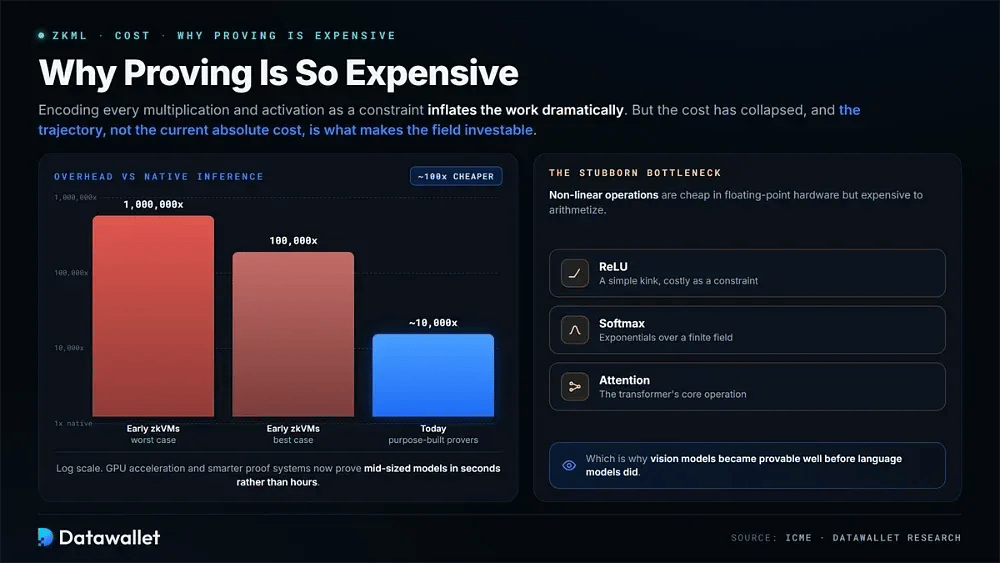
Il problema dei costi è aritmetico, non accidentale. Codificare come vincolo ogni moltiplicazione e attivazione in una rete neurale fa aumentare enormemente il lavoro, ed è per questo che i primi approcci zkVM comportavano costi aggiuntivi compresi tra 100.000 e 1.000.000 volte l'inferenza nativa.
Quella cifra è crollata. Prover costruiti ad hoc, accelerazione GPU e sistemi di prova più intelligenti hanno ridotto il sovraccarico verso un intervallo di 10.000 volte, e framework specializzati ora dimostrano modelli di medie dimensioni in secondi anziché in ore. È la traiettoria, non il costo assoluto attuale, a rendere il settore investibile.
Le operazioni non lineari restano il collo di bottiglia più ostinato. Funzioni di attivazione come ReLU e softmax, insieme ai meccanismi di attenzione nei transformer, sono economiche sull'hardware in virgola mobile ma costose da aritmetizzare, ed è per questo che i modelli di visione sono diventati dimostrabili molto prima dei modelli linguistici.
Framework e strumenti zkML nel 2026
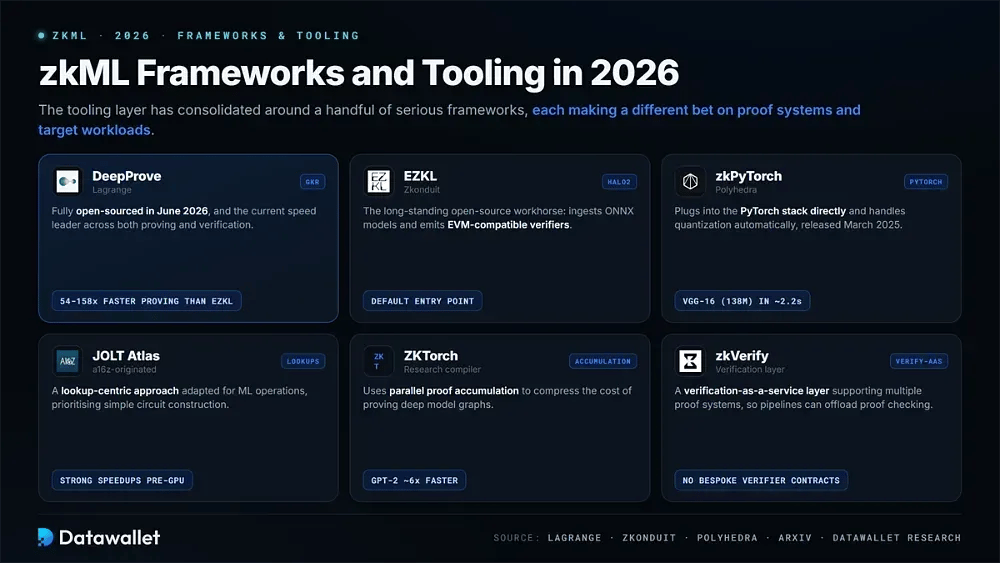
Il livello degli strumenti si è consolidato attorno a una manciata di framework seri, ciascuno con una scommessa diversa su sistemi di prova e carichi di lavoro di destinazione. Questi sono i progetti che definiscono lo stato dell'arte:
- DeepProve: la libreria basata su GKR di Lagrange, resa interamente open source a giugno 2026, risulta nei benchmark da 54 a 158 volte più veloce di EZKL nella generazione delle prove e fino a 671 volte più veloce nella verifica.
- EZKL: lo storico cavallo di battaglia open source basato su Halo2, che acquisisce modelli ONNX ed emette verificatori compatibili con EVM, diventando il punto di ingresso predefinito per gli sviluppatori senza competenze di crittografia.
- zkPyTorch: un compilatore di Polyhedra rilasciato a marzo 2025 che si integra direttamente nello stack di PyTorch, gestisce automaticamente la quantizzazione e dimostra il VGG-16 da 138 milioni di parametri in circa 2,2 secondi.
- JOLT Atlas: un approccio nato in a16z, incentrato sui lookup e adattato alle operazioni di ML, che privilegia una costruzione semplice dei circuiti e ottiene forti accelerazioni ancor prima dell'applicazione dell'accelerazione GPU.
- ZKTorch: un compilatore di ricerca che usa l'accumulo parallelo di prove, riportato come in grado di dimostrare GPT-2 circa sei volte più velocemente dei precedenti sistemi ZKML generici a parità di hardware.
- zkVerify: un livello di verifica come servizio che supporta più sistemi di prova, consentendo alle pipeline di IA di delegare il controllo delle prove invece di distribuire contratti di verifica su misura per ogni modello.
Il benchmark che ha cambiato le aspettative
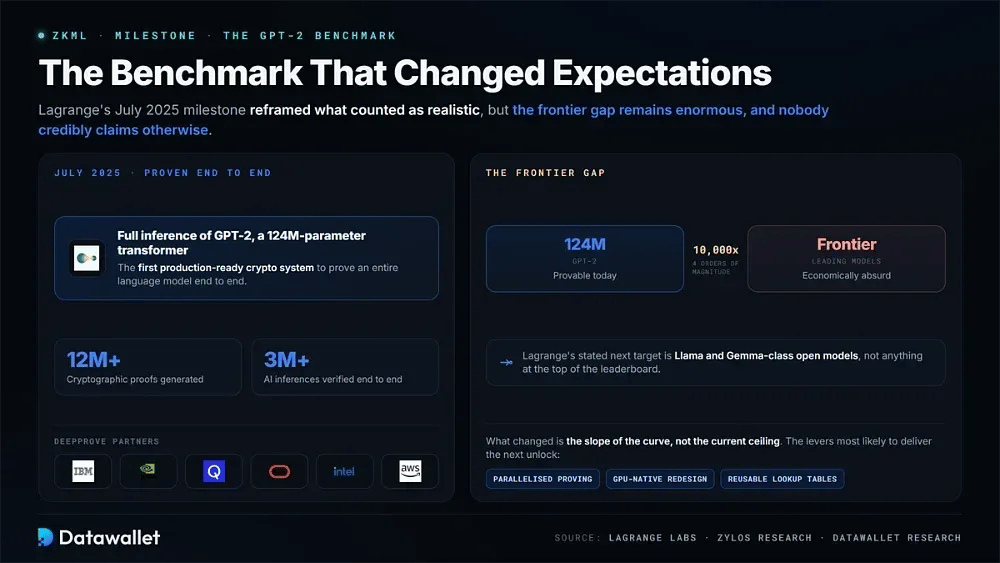
La pietra miliare raggiunta da Lagrange a luglio 2025 ha cambiato ciò che si considerava realistico. Il team ha completato un' inferenza completa di GPT-2, un transformer da 124 milioni di parametri, diventando il primo sistema crypto pronto per la produzione a dimostrare un intero modello linguistico end to end.
Il sistema è poi passato dalla demo alla messa in produzione. Lagrange ha rilasciato DeepProve come open source a giugno 2026, dichiarando più di 12 milioni di prove crittografiche generate e oltre 3 milioni di inferenze IA verificate end to end, insieme a partnership con IBM, NVIDIA, Qualcomm, Oracle, Intel e AWS.
Il divario rispetto alla frontiera resta comunque enorme e nessuno sostiene credibilmente il contrario. GPT-2 è quattro ordini di grandezza più piccolo dei modelli leader di oggi, quindi dimostrare un sistema di frontiera moderno non è solo costoso ma economicamente assurdo, e il prossimo obiettivo dichiarato di Lagrange sono i modelli aperti di classe Llama e Gemma, non qualcosa al vertice della classifica.
Ciò che è cambiato è la pendenza della curva, più che il limite attuale. La dimostrazione parallelizzata su cluster di prover, la riprogettazione degli algoritmi nativi per GPU e le lookup table riutilizzabili sono le leve con più probabilità di portare al prossimo salto di un ordine di grandezza, avvicinando gradualmente i modelli aperti di medie dimensioni a un intervallo dimostrabile.
Casi d'uso di zkML nelle crypto
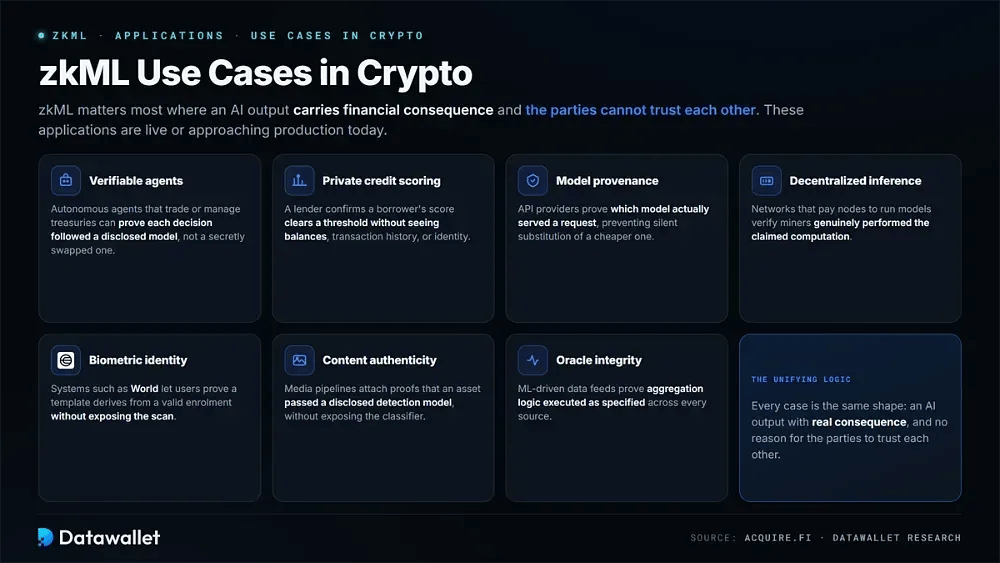
zkML è più importante dove un risultato dell'IA ha conseguenze finanziarie e le parti non possono fidarsi l'una dell'altra. Queste applicazioni sono già attive o prossime alla produzione:
- Agenti verificabili: gli agenti IA autonomi che fanno trading o gestiscono tesorerie possono dimostrare che ogni decisione ha seguito un modello dichiarato e non uno sostituito di nascosto, colmando il divario tra mandante e agente.
- Credit scoring privato: un protocollo di prestito può confermare che il punteggio di un mutuatario superi una soglia senza mai vedere saldi, cronologia delle transazioni o identità, poiché la prova attesta che il modello è stato eseguito correttamente.
- Provenienza del modello: i fornitori di API possono dimostrare quale modello abbia effettivamente servito una richiesta, evitando la sostituzione silenziosa con un modello più economico mentre ne viene fatturato uno costoso.
- Inferenza decentralizzata: le reti che pagano i nodi per eseguire i modelli usano zkML per verificare che i miner abbiano davvero svolto il calcolo dichiarato, sostituendo la reputazione con un regolamento crittografico.
- Identità biometrica: sistemi come World possono permettere agli utenti di dimostrare che un nuovo modello biometrico deriva da una registrazione valida, senza una nuova verifica centralizzata e senza esporre la scansione originale.
- Autenticità dei contenuti: le pipeline multimediali possono allegare prove che dimostrano che un asset ha superato un modello di rilevamento reso noto, offrendo ai regolatori una traccia verificabile senza esporre il classificatore proprietario.
- Integrità degli oracoli: i feed di dati basati su ML possono dimostrare che la logica di aggregazione è stata eseguita come specificato tra le diverse fonti, rafforzando il bridge tra intelligence off-chain e regolamento on-chain.
Applicazioni DeFi emergenti
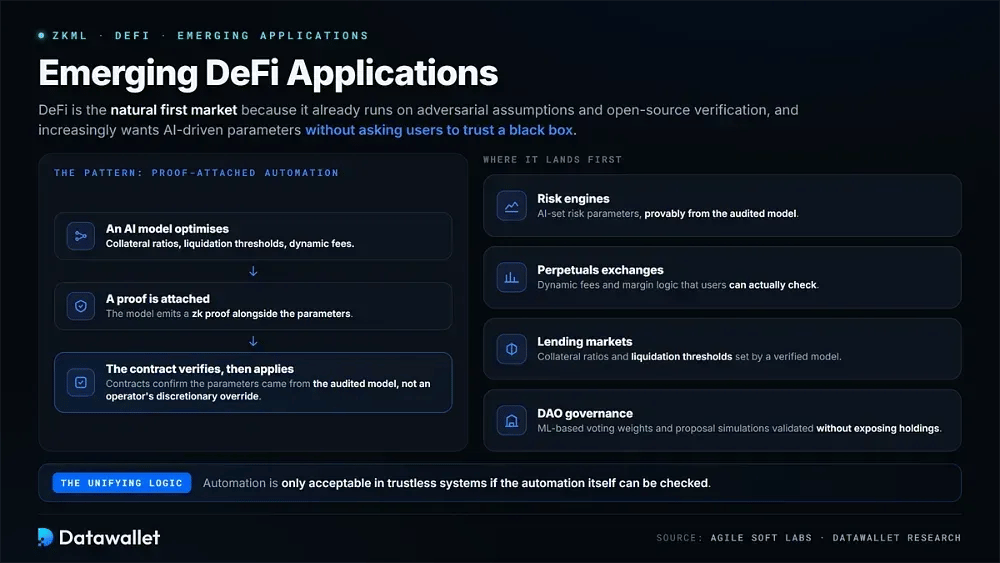
La finanza decentralizzata è il primo mercato naturale perché funziona già su ipotesi avversarie e verifica open source. I motori di rischio, gli exchange di perpetual e i mercati di prestito vogliono sempre più parametri guidati dall'IA senza chiedere agli utenti di fidarsi di una scatola nera.
Lo schema è l'automazione con prova allegata. Un modello di IA ottimizza i rapporti di collateral, le soglie di liquidazione o le commissioni dinamiche, e la prova che lo accompagna permette ai contratti del protocollo di verificare che i parametri provengano dal modello sottoposto ad audit e non da un intervento discrezionale di un operatore.
La governance delle DAO è una seconda frontiera, in cui i pesi di voto basati su ML o le simulazioni delle proposte possono essere convalidati senza rivelare le posizioni dei singoli detentori. La logica comune è che l'automazione è accettabile nei sistemi trustless solo se l'automazione stessa può essere verificata.
Il mercato zkML e i progetti principali
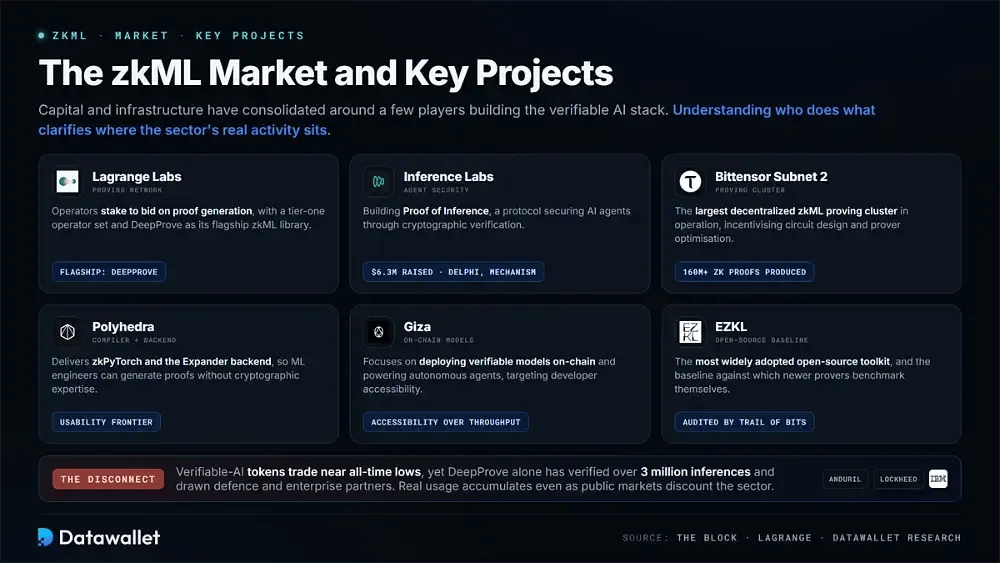
Capitali e infrastrutture si sono concentrati attorno a pochi operatori che costruiscono lo stack di IA verificabile. Capire chi fa cosa chiarisce dove si concentri l'attività reale del settore:
- Lagrange Labs: gestisce una rete di proving in cui gli operatori fanno stake per aggiudicarsi la generazione delle prove, con un insieme di operatori di primo livello e DeepProve come libreria zkML di punta per l'inferenza IA.
- Inference Labs: ha raccolto 6,3 milioni di dollari da investitori tra cui Delphi e Mechanism per sviluppare Proof of Inference, un protocollo che protegge gli agenti IA tramite verifica crittografica.
- Bittensor Subnet 2: il più grande cluster decentralizzato di prova zkML in funzione, che ha prodotto oltre 160 milioni di prove zero-knowledge incentivando la progettazione dei circuiti e l'ottimizzazione dei prover.
- Polyhedra: fornisce il compilatore zkPyTorch e il backend di prova Expander, spingendo più in là la frontiera dell'usabilità, così che gli ingegneri ML possano generare prove senza competenze crittografiche.
- Giza: si concentra sull'implementazione di modelli verificabili on-chain e sull'alimentazione di agenti autonomi, puntando sull'accessibilità per gli sviluppatori piuttosto che sulla pura capacità di elaborazione delle prove.
- EZKL: mantiene il toolkit open source più diffuso, sottoposto ad audit da Trail of Bits, e funge da riferimento rispetto al quale si misurano i nuovi prover.
Il quadro commerciale è più sfumato di quanto ammettano rialzisti o ribassisti. I prezzi dei token di IA verificabile hanno sofferto molto e diversi sono vicini ai minimi storici, eppure DeepProve da solo ha verificato oltre tre milioni di inferenze e ha attirato partner del settore difesa e aziendale tra cui Anduril, Lockheed Martin e IBM, quindi l'uso reale si accumula anche mentre i mercati pubblici scontano il settore.
Regolamentazione e il caso della conformità per zkML
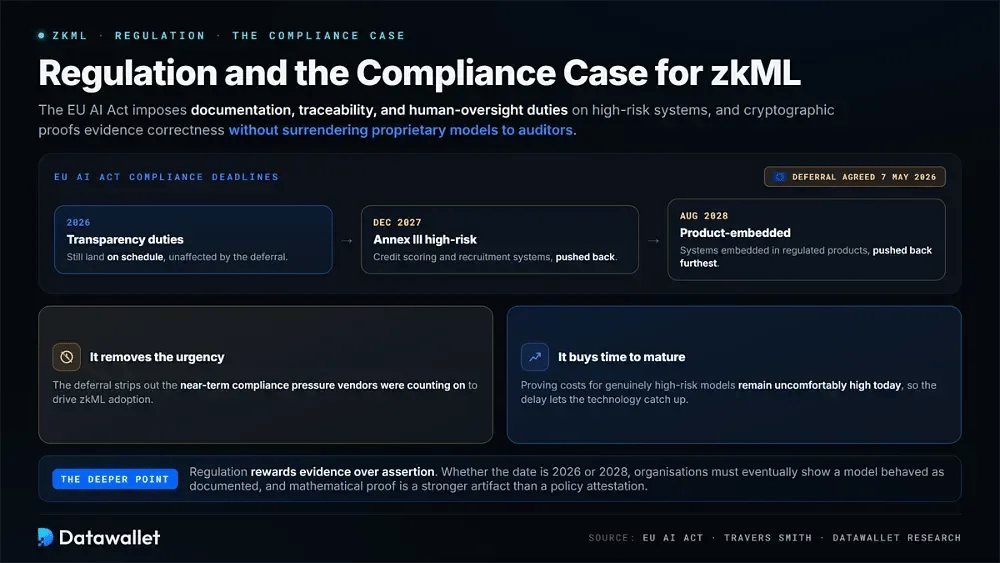
La pressione normativa è l'argomento non crypto più forte a favore di un'IA verificabile. L'AI Act dell'UE impone obblighi di documentazione, tracciabilità e supervisione umana ai sistemi ad alto rischio, e le prove crittografiche offrono un modo per dimostrare la correttezza senza cedere ai revisori i modelli proprietari.
Nel 2026 le tempistiche sono cambiate in modo significativo. I legislatori dell'UE hanno raggiunto un accordo politico il 7 maggio 2026 per rinviare gli obblighi più pesanti per i sistemi ad alto rischio, spostando i sistemi dell'Allegato III, come il credit scoring e la selezione del personale, a dicembre 2027 e i sistemi integrati nei prodotti ad agosto 2028, mentre gli obblighi di trasparenza restano in vigore nel 2026.
Questo rinvio ha due facce per zkML. Elimina l'urgenza di conformità a breve termine su cui contavano i fornitori, ma dà anche alla tecnologia il tempo di maturare prima delle scadenze, dato che i costi di prova per i modelli davvero ad alto rischio restano oggi scomodamente alti.
Il punto più profondo è che la regolamentazione premia le prove rispetto alle dichiarazioni. Che la data di applicazione sia il 2026 o il 2028, le organizzazioni dovranno prima o poi dimostrare che un modello implementato si è comportato come documentato, e la prova matematica è un artefatto più solido di un'attestazione di policy.
zkML, identità digitale e l'ondata della verifica dell'età
La più grande applicazione reale della crittografia zero-knowledge non avviene affatto nel mondo crypto, ma nell'identità digitale, spinta dagli obblighi di verifica dell'età in corso di introduzione in Europa, nel Regno Unito e oltre.
Questo è importante per zkML perché costruisce i canali per le credenziali, l'infrastruttura dei wallet e la familiarità del pubblico da cui l'IA verificabile finirà per dipendere, anche se le due tecnologie risolvono problemi diversi.
Il lancio globale dell'identità zk
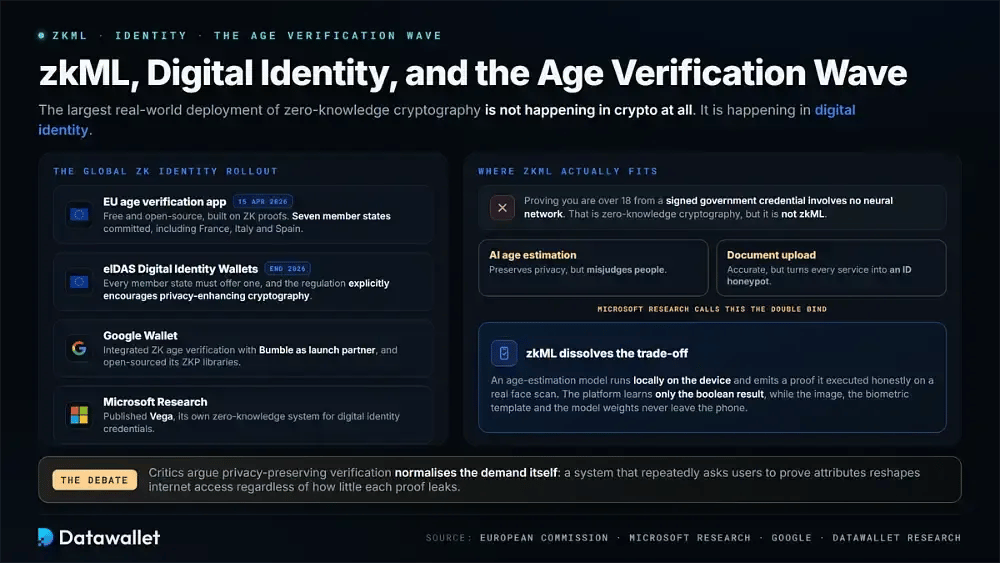
Il 15 aprile 2026 la Commissione europea ha lanciato un'app gratuita e open source per la verifica dell'età, basata sulla crittografia a prova a conoscenza zero (zero-knowledge) che permette agli utenti di dimostrare di superare una soglia di età senza rivelare la data di nascita o l'identità. Sette Stati membri, tra cui Francia, Italia e Spagna, si sono impegnati a integrarla.
L'infrastruttura che le sta sotto è ancora più ampia. Il regolamento eIDAS riveduto impone a ogni Stato membro dell'UE di offrire un Digital Identity Wallet entro la fine del 2026 e incoraggia esplicitamente la crittografia a tutela della privacy, mentre l'Online Safety Act del Regno Unito e il Digital Services Act forniscono la pressione normativa che rende l'adozione inevitabile.
Anche il settore privato si è mosso in parallelo. Google ha integrato la verifica dell'età con ZK in Google Wallet con Bumble come partner di lancio e ha reso open source le sue librerie ZKP, mentre Microsoft Research ha pubblicato Vega, il proprio sistema zero-knowledge per le credenziali di identità digitale.
Dove zkML trova davvero applicazione
Vale la pena chiarire con semplicità una distinzione importante, perché viene spesso confusa. Dimostrare di avere più di diciotto anni a partire da una credenziale governativa firmata non richiede alcuna rete neurale: è crittografia zero-knowledge, ma non zkML. Le due condividono la matematica, non i meccanismi.
La vera sovrapposizione riguarda la stima dell'età. Le piattaforme soggette a obblighi di verifica devono scegliere tra la stima basata sull'IA, che tutela la privacy ma giudica male le persone, e il caricamento di documenti, che è accurato ma trasforma ogni servizio in un honeypot per i dati dei documenti d'identità governativi. Microsoft Research lo definisce il doppio vincolo.
zkML è ciò che risolve questo compromesso. Un modello di stima dell'età può essere eseguito localmente sul dispositivo dell'utente ed emettere una prova che il modello dichiarato è stato eseguito correttamente su una scansione reale del volto, così la piattaforma apprende solo il risultato booleano, mentre l'immagine, il template biometrico e i pesi del modello non lasciano mai il telefono.
Chat Control e il dibattito sulla sorveglianza
La stessa crittografia si colloca in modo scomodo all'interno delle controverse proposte europee di Chat Control, in cui la scansione obbligatoria dei messaggi privati è stata giustificata con obiettivi di tutela dei minori. Sia la scansione lato client sia zkML promettono verifica senza un'esposizione massiccia dei dati, il che rende questa impostazione politicamente potente.
I critici di questi sistemi sostengono che la verifica che preserva la privacy normalizza la richiesta stessa, poiché un sistema che chiede ripetutamente agli utenti di provare degli attributi ridefinisce l'accesso a internet, indipendentemente da quanti pochi dati ogni singola prova riveli. I gruppi per i diritti digitali si sono opposti al collegamento dei controlli dell'età ai wallet di identità proprio per questo motivo.
Per zkML la lezione è scomoda ma utile. La verificabilità crittografica è uno strumento di privacy davvero potente, ma è anche un fattore abilitante dei regimi di conformità, e il significato politico della tecnologia dipende interamente da ciò di cui le istituzioni scelgono di pretendere la prova.
zkML a confronto con altri approcci di IA verificabile
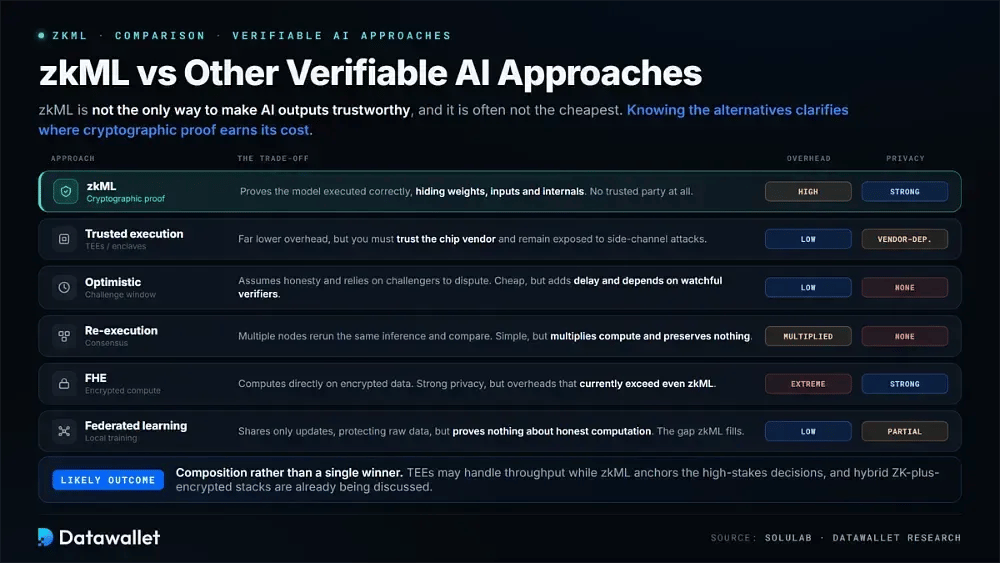
zkML non è l'unico modo per rendere affidabili gli output dell'IA e spesso non è il più economico. Comprendere le alternative chiarisce dove la prova crittografica giustifica davvero il suo costo:
- Trusted execution environment: i TEE eseguono i modelli all'interno di enclave hardware sicure e attestano il risultato, con un sovraccarico molto inferiore, ma richiedono fiducia nel produttore del chip e restano esposti ad attacchi side-channel.
- Verifica ottimistica: i sistemi presumono che i calcoli siano onesti e si affidano a sfidanti che li contestino entro una finestra di tempo; è un metodo economico, ma introduce ritardi e dipende da verificatori attenti e motivati economicamente.
- Riesecuzione per consenso: più nodi rieseguono la stessa inferenza e confrontano i risultati, un approccio semplice che moltiplica il costo di calcolo e non può preservare la riservatezza degli input o dei pesi.
- Crittografia completamente omomorfica: la FHE elabora direttamente i dati cifrati, offrendo una forte privacy ma comportando costi prestazionali che attualmente superano persino quelli di zkML per la maggior parte dei carichi di lavoro di machine learning.
- Apprendimento federato: l'addestramento avviene in locale e vengono condivisi solo gli aggiornamenti, proteggendo i dati grezzi senza dimostrare che ogni partecipante abbia calcolato in modo onesto, il che lascia una lacuna di integrità che zkML può colmare.
Il risultato più probabile è una composizione, più che un unico vincitore. Si discute già di stack ibridi che abbinano prove ZK e calcolo cifrato per i carichi di lavoro cloud più sensibili, e i TEE potrebbero gestire il throughput mentre zkML ancora le decisioni ad alto rischio.
Rischi e limitazioni
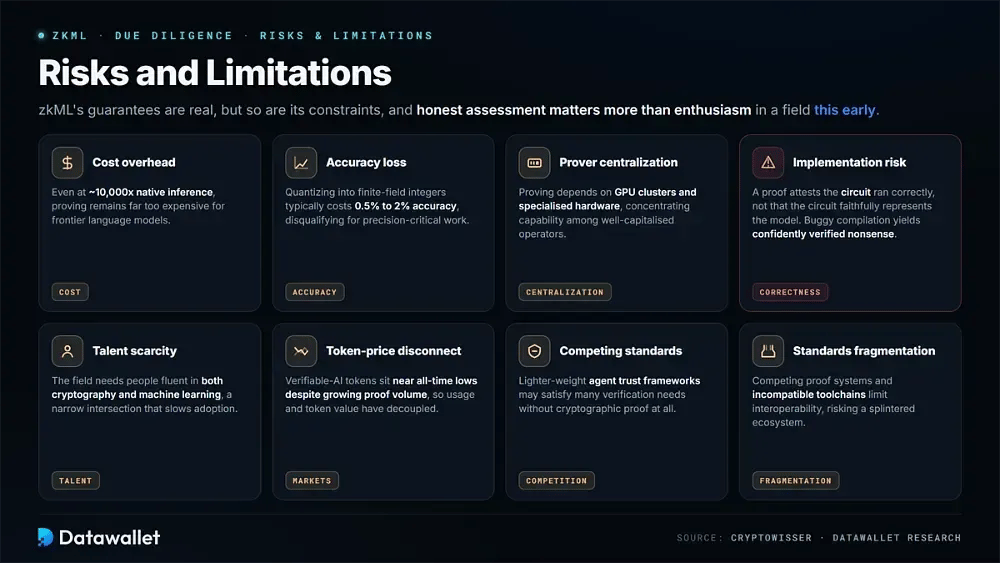
Le garanzie di zkML sono reali, ma lo sono anche i suoi limiti, e in un settore ancora così giovane una valutazione onesta conta più dell'entusiasmo. Le principali criticità sono:
- Costi aggiuntivi: Anche con un rapporto di circa 10.000 volte rispetto all'inferenza nativa, la generazione delle prove resta troppo costosa per i modelli linguistici di frontiera, limitando zkML a modelli più piccoli e ben definiti per il prossimo futuro.
- Perdita di accuratezza: quantizzare pesi in virgola mobile in interi di campo finito costa in genere 0,5 a 2% di accuratezza, un compromesso accettabile per molte attività ma inaccettabile per le applicazioni in cui la precisione è critica.
- Centralizzazione dei prover: la generazione delle prove dipende sempre più da cluster di GPU e hardware specializzato, concentrando la capacità tra operatori ben capitalizzati e minando la decentralizzazione che la tecnologia dovrebbe servire.
- Rischio di implementazione: una prova attesta solo che un circuito è stato eseguito correttamente, non che il circuito rappresenti fedelmente il modello previsto, quindi una compilazione difettosa può produrre risultati privi di senso ma verificati con sicurezza.
- Scarsità di talenti: Il settore richiede persone esperte sia di crittografia sia di machine learning, un'intersezione ristretta che rallenta l'adozione da parte delle aziende, indipendentemente da quanto diventino validi gli strumenti sottostanti.
- Scollamento del prezzo dei token: i token di IA verificabile scambiano vicino ai minimi storici nonostante il crescente volume di prove, quindi l'utilizzo dell'infrastruttura e il valore dei token si sono disaccoppiati e chi li detiene non può dare per scontato che l'adozione si traduca in prezzo.
- Standard concorrenti: i framework di fiducia per agenti più leggeri possono soddisfare molte esigenze di verifica senza prova crittografica, intercettando casi d'uso che zkML si aspettava di dominare.
- Frammentazione degli standard: sistemi di prova concorrenti e toolchain incompatibili limitano l'interoperabilità, e senza convergenza l'adozione potrebbe frammentarsi tra ecosistemi che non possono verificare il lavoro l'uno dell'altro.
Considerazioni finali
zkML è passato da curiosità di ricerca a infrastruttura funzionante. È stata dimostrata un'inferenza completa di GPT-2, i modelli di visione di medie dimensioni si dimostrano in pochi secondi e l'overhead è diminuito di due ordini di grandezza in circa due anni, una curva di miglioramento più rapida di quella raggiunta dalla maggior parte delle primitive crittografiche.
Il vincolo, onestamente, è che il divario tra ciò che è dimostrabile e ciò che è effettivamente in uso resta ampio. I modelli di frontiera sono quattro ordini di grandezza oltre la portata economica, l'hardware dei prover si concentra tra operatori ben capitalizzati e i token del settore scambiano molto al di sotto delle aspettative dell'epoca dei finanziamenti, anche se il volume di proof cresce.
Il caso strategico si basa su dove sta andando l'IA, più che su dove si trova oggi. Gli agenti autonomi iniziano a muovere capitali reali, le autorità di regolamentazione chiedono un comportamento dimostrabile dei modelli e le infrastrutture di identità zero-knowledge ora in fase di diffusione in Europa stanno normalizzando silenziosamente la prova crittografica come infrastruttura quotidiana. Per chi segue la convergenza tra IA e crypto, zkML è il livello in cui queste traiettorie si incontrano.