Was ist Zero-Knowledge Machine Learning (zkML)?
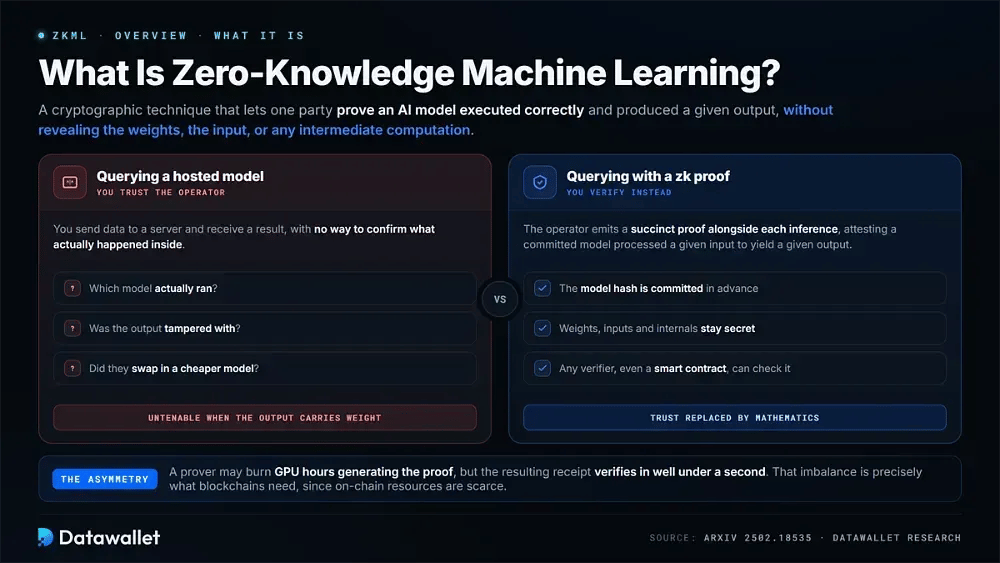
Zero-knowledge Machine Learning ist ein kryptografisches Verfahren, mit dem eine Partei beweisen kann, dass ein KI-Modell korrekt ausgeführt wurde und eine bestimmte Ausgabe erzeugt hat, ohne die Gewichte des Modells, die Eingabedaten oder Zwischenberechnungen offenzulegen. Es wandelt die Behauptung der Korrektheit in ein mathematisches Objekt um, das jeder überprüfen kann.
Das Problem, das es löst, ist struktureller Natur. Wenn Sie ein gehostetes Modell abfragen, senden Sie Daten an einen Server und erhalten ein Ergebnis, ohne bestätigen zu können, welches Modell tatsächlich lief, ob die Ausgabe manipuliert wurde oder ob der Anbieter ein günstigeres Modell untergeschoben hat. Man muss ihm vollständig vertrauen, was unhaltbar ist, wenn die Ausgabe finanzielles, medizinisches oder rechtliches Gewicht hat.
zkML ersetzt dieses Vertrauen durch Verifikation. Der Modellbetreiber erzeugt zu jeder Inferenz einen kompakten kryptografischen Beweis, der bestätigt, dass ein bestimmtes festgelegtes Modell eine bestimmte Eingabe verarbeitet hat, um eine bestimmte Ausgabe zu erzeugen. Der Beweis enthält keine der geheimen Daten, doch jede dritte Partei, auch ein Smart Contract, kann ihn in Millisekunden prüfen.
Die Asymmetrie macht es praktikabel. Die Berechnung kann teuer sein, während die Verifizierung günstig bleibt: Ein Prover verbraucht womöglich GPU-Stunden für die Erzeugung des Beweises, doch der Nachweis wird in <1 Sekunde verifiziert. Genau dieses Ungleichgewicht brauchen Blockchains, da Onchain-Ressourcen knapp sind und die Nutzung einer off-chain erzeugten KI-Ausgabe sonst Vertrauen in ein Orakel erfordert.
Wie funktioniert zkML?
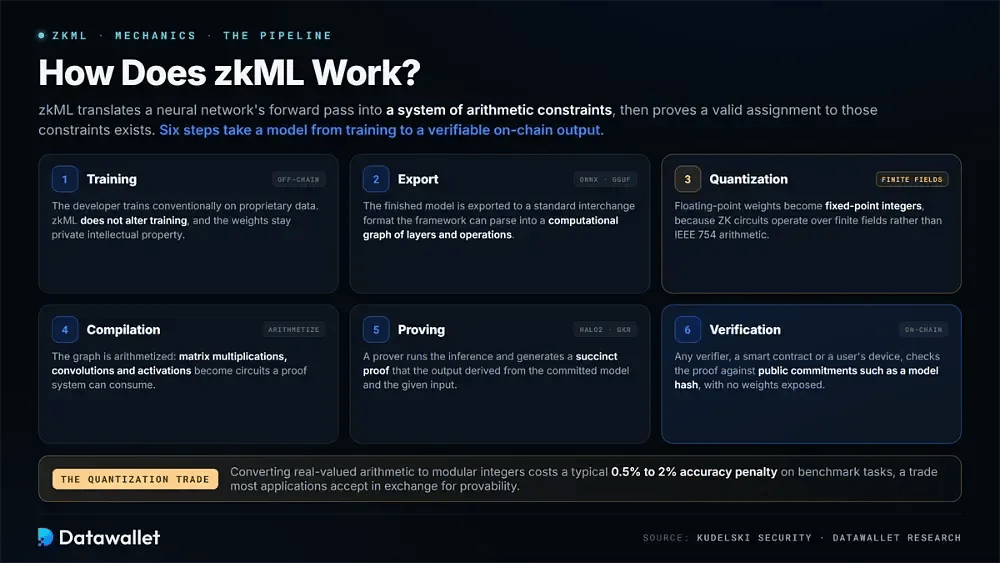
zkML überführt den Forward Pass eines neuronalen Netzes in ein System aus arithmetischen Bedingungen und beweist dann, dass eine gültige Belegung dieser Bedingungen existiert.
So gelangt ein Modell vom Training zu einem überprüfbaren on-chain-Ergebnis:
- Training: Der Entwickler trainiert ein Modell konventionell, off-chain, mit eigenen Daten und Techniken. zkML verändert das Training selbst nicht, und die resultierenden Gewichte bleiben privates geistiges Eigentum.
- Export: Das fertige Modell wird in ein Standard-Austauschformat exportiert, typischerweise ONNX oder GGUF, das das Proving-Framework in einen Berechnungsgraphen aus Schichten und Operationen zerlegen kann.
- Quantisierung: Gleitkommagewichte werden als Festkommazahlen angenähert, da ZK-Schaltkreise über endlichen Körpern statt mit IEEE-754-Arithmetik arbeiten. Dieser Schritt kostet ein wenig Genauigkeit.
- Kompilierung: Das Framework arithmetisiert den Graphen und wandelt Matrixmultiplikationen, Faltungen und nichtlineare Aktivierungen in Schaltkreise oder Constraint-Systeme um, die ein Beweissystem verarbeiten kann.
- Beweisen: Ein Prover führt die Inferenz aus und erzeugt einen kompakten Beweis, der die Ausgabe bestätigt, die aus dem festgelegten Modell und der gegebenen Eingabe abgeleitet wurde. Dabei kommen Systeme wie Halo2, GKR oder Lookup-basierte Argumente zum Einsatz.
- Verifizierung: Jeder Verifizierer, ein Smart Contract, ein Prüfer oder das Gerät eines Nutzers, prüft den Zero-Knowledge-Beweis anhand öffentlicher Verpflichtungen wie eines Modell-Hashs und bestätigt die Korrektheit, ohne Gewichte oder Rohdaten offenzulegen.
Der Quantisierungsschritt verdient Aufmerksamkeit, weil hier kryptografische Strenge auf die Realität des maschinellen Lernens trifft. Die Umwandlung von reellwertiger Arithmetik in modulare Ganzzahlarithmetik führt bei Benchmark-Aufgaben typischerweise zu einem Genauigkeitsverlust von etwa 0,5 bis 2 %, ein Kompromiss, den die meisten Anwendungen für die Beweisbarkeit akzeptieren.
Warum das Beweisen so teuer ist
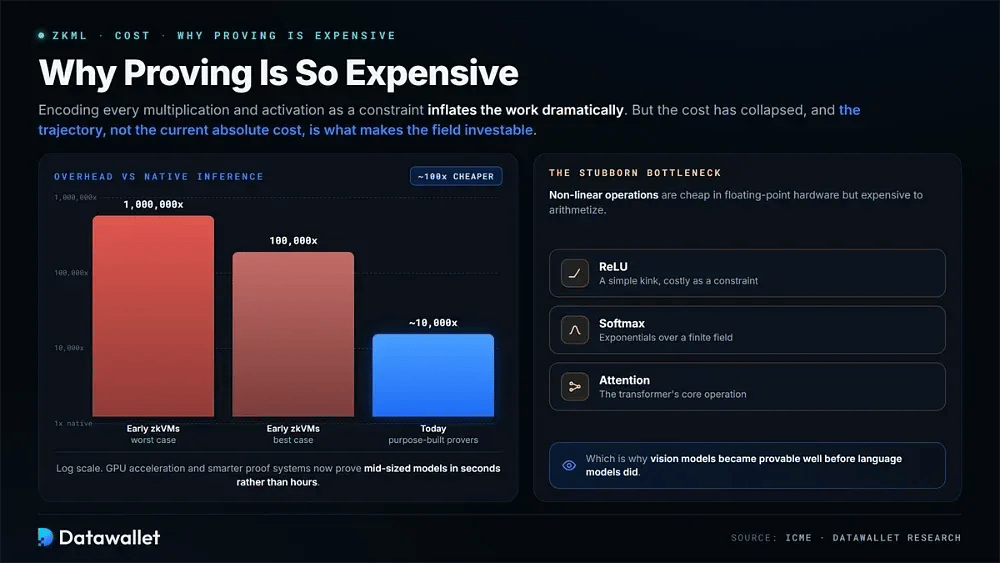
Das Kostenproblem ist rechnerischer Natur und kein Zufall. Wenn jede Multiplikation und Aktivierung in einem neuronalen Netz als Constraint kodiert wird, steigt der Aufwand dramatisch, weshalb frühe zkVM-Ansätze Overheads zwischen dem 100.000- und dem 1.000.000-Fachen der nativen Inferenz aufwiesen.
Diese Zahl ist stark gesunken. Speziell entwickelte Prover, GPU-Beschleunigung und intelligentere Beweissysteme haben den Mehraufwand auf das 10.000-Fache gedrückt, und spezialisierte Frameworks beweisen mittelgroße Modelle inzwischen in Sekunden statt Stunden. Die Entwicklung, nicht die aktuellen absoluten Kosten, macht den Bereich investierbar.
Nichtlineare Operationen bleiben der hartnäckige Engpass. Aktivierungen wie ReLU und Softmax sowie Aufmerksamkeitsmechanismen in Transformern sind auf Gleitkomma-Hardware günstig, aber aufwendig zu arithmetisieren. Deshalb wurden Bildmodelle lange vor Sprachmodellen beweisbar.
zkML-Frameworks und Tooling im Jahr 2026
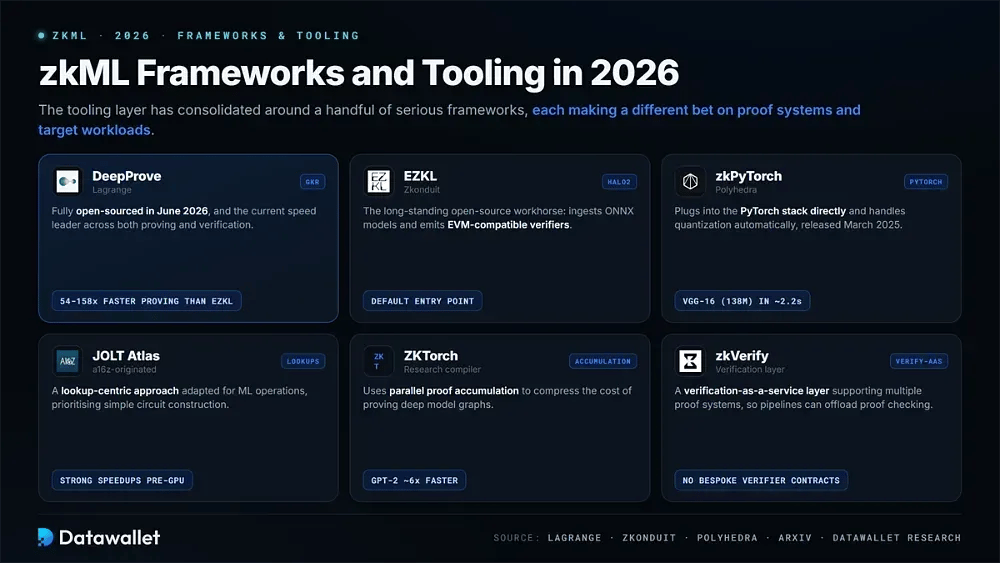
Die Tooling-Ebene hat sich um eine Handvoll ernstzunehmender Frameworks konsolidiert, die jeweils unterschiedlich auf Beweissysteme und Ziel-Workloads setzen. Diese Projekte bestimmen den Stand der Technik:
- DeepProve: Die GKR-basierte Bibliothek von Lagrange, im Juni 2026 vollständig als Open Source veröffentlicht, ist in Benchmarks bei der Beweiserstellung 54- bis 158-mal schneller als EZKL und bei der Verifizierung bis zu 671-mal schneller.
- EZKL: Das langjährige Open-Source-Arbeitspferd auf Basis von Halo2, das ONNX-Modelle einliest und EVM-kompatible Verifizierer ausgibt. Damit ist es der Standardeinstieg für Entwickler ohne kryptografischen Hintergrund.
- zkPyTorch: Ein im März 2025 veröffentlichter Polyhedra-Compiler, der sich direkt in den PyTorch-Stack einfügt, die Quantisierung automatisch übernimmt und das VGG-16 mit 138 Millionen Parametern in rund 2,2 Sekunden beweist.
- JOLT Atlas: Ein von a16z stammender, Lookup-zentrierter Ansatz, angepasst an ML-Operationen, der einfache Schaltkreiskonstruktion priorisiert und bereits vor dem Einsatz von GPU-Beschleunigung deutliche Beschleunigungen erzielt.
- ZKTorch: Ein Forschungs-Compiler, der parallele Proof-Akkumulation nutzt und Berichten zufolge GPT-2 auf identischer Hardware etwa sechsmal schneller beweist als frühere universelle ZKML-Systeme.
- zkVerify: Eine Verification-as-a-Service-Schicht, die mehrere Beweissysteme unterstützt und es KI-Pipelines ermöglicht, die Beweisprüfung auszulagern, statt für jedes Modell eigene Verifier-Contracts bereitzustellen.
Der Maßstab, der die Erwartungen veränderte
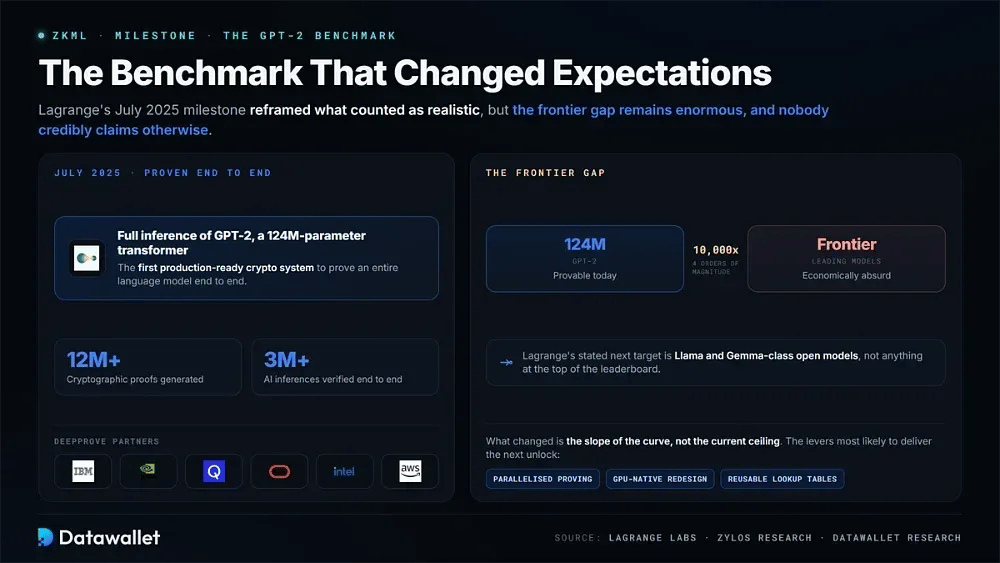
Der Meilenstein von Lagrange im Juli 2025 veränderte, was als realistisch galt. Das Team führte eine vollständige Inferenz von GPT-2 durch, einem Transformer mit 124 Millionen Parametern, und bewies damit als erstes produktionsreifes Kryptosystem ein gesamtes Sprachmodell durchgängig.
Danach ging das System von der Demo in den Einsatz über. Lagrange hat DeepProve im Juni 2026 als Open Source veröffentlicht und dabei mehr als 12 Millionen erzeugte kryptografische Beweise sowie über 3 Millionen durchgängig verifizierte KI-Inferenzen offengelegt, zusammen mit Partnerschaften unter anderem mit IBM, NVIDIA, Qualcomm, Oracle, Intel und AWS.
Dennoch bleibt die Lücke zur Spitze enorm, und niemand behauptet glaubwürdig etwas anderes. GPT-2 ist vier Größenordnungen kleiner als die heutigen führenden Modelle. Ein modernes Spitzensystem zu beweisen ist daher nicht bloß teuer, sondern wirtschaftlich absurd, und Lagranges erklärtes nächstes Ziel sind offene Modelle der Klasse Llama und Gemma statt etwas an der Spitze der Rangliste.
Geändert hat sich die Steigung der Kurve, nicht die aktuelle Obergrenze. Parallelisiertes Proving über Prover-Cluster, GPU-native Neuentwürfe von Algorithmen und wiederverwendbare Lookup-Tabellen sind die Hebel, die am ehesten den nächsten Sprung um eine Größenordnung bringen und mittelgroße offene Modelle schrittweise in den beweisbaren Bereich ziehen.
zkML-Anwendungsfälle in der Kryptowelt
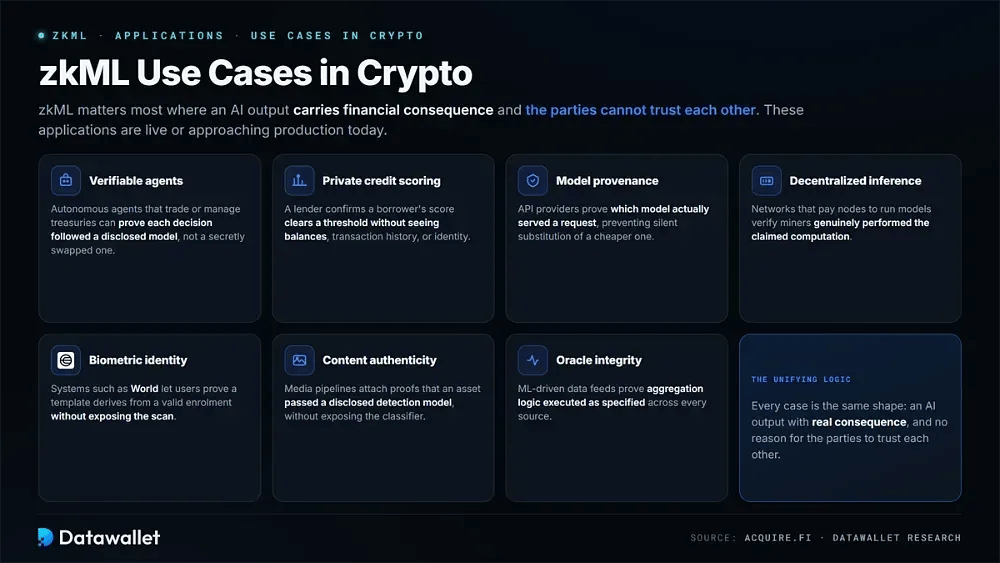
zkML ist dort am wichtigsten, wo das Ergebnis einer KI finanzielle Folgen hat und die Parteien einander nicht vertrauen können. Diese Anwendungen sind heute bereits live oder stehen kurz vor dem Produktiveinsatz:
- Verifizierbare Agenten: Autonome KI-Agenten, die handeln oder Treasurys verwalten, können belegen, dass jede Entscheidung auf einem offengelegten Modell beruhte und nicht auf einem heimlich ausgetauschten, und so die Principal-Agent-Lücke schließen.
- Private Bonitätsbewertung: Ein Lending-Protokoll kann bestätigen, dass die Bewertung eines Kreditnehmers einen Schwellenwert erreicht, ohne jemals Kontostände, Transaktionshistorie oder Identität zu sehen, da der Nachweis bestätigt, dass das Modell korrekt ausgeführt wurde.
- Modellherkunft: API-Anbieter können nachweisen, welches Modell eine Anfrage tatsächlich bearbeitet hat, und so verhindern, dass unbemerkt ein günstigeres Modell eingesetzt wird, während ein teures abgerechnet wird.
- Dezentrale Inferenz: Netzwerke, die Nodes für das Ausführen von Modellen bezahlen, nutzen zkML, um zu überprüfen, dass Miner die angegebene Berechnung tatsächlich durchgeführt haben, und ersetzen Reputation durch kryptografische Abwicklung.
- Biometrische Identität: Systeme wie World können es Nutzern ermöglichen nachzuweisen, dass eine neue biometrische Vorlage aus einer gültigen Registrierung stammt, ohne zentrale Neuverifizierung und ohne den zugrunde liegenden Scan offenzulegen.
- Authentizität von Inhalten: Medien-Pipelines können Nachweise anhängen, die zeigen, dass ein Asset ein offengelegtes Erkennungsmodell durchlaufen hat. So erhalten Aufsichtsbehörden einen prüfbaren Nachweis, ohne dass der proprietäre Klassifikator offengelegt wird.
- Oracle-Integrität: KI-gestützte Datenfeeds können nachweisen, dass die Aggregationslogik über mehrere Quellen hinweg wie vorgegeben ausgeführt wurde, und stärken so den Bridge zwischen off-chain-Intelligenz und on-chain-Abwicklung.
Neue DeFi-Anwendungen
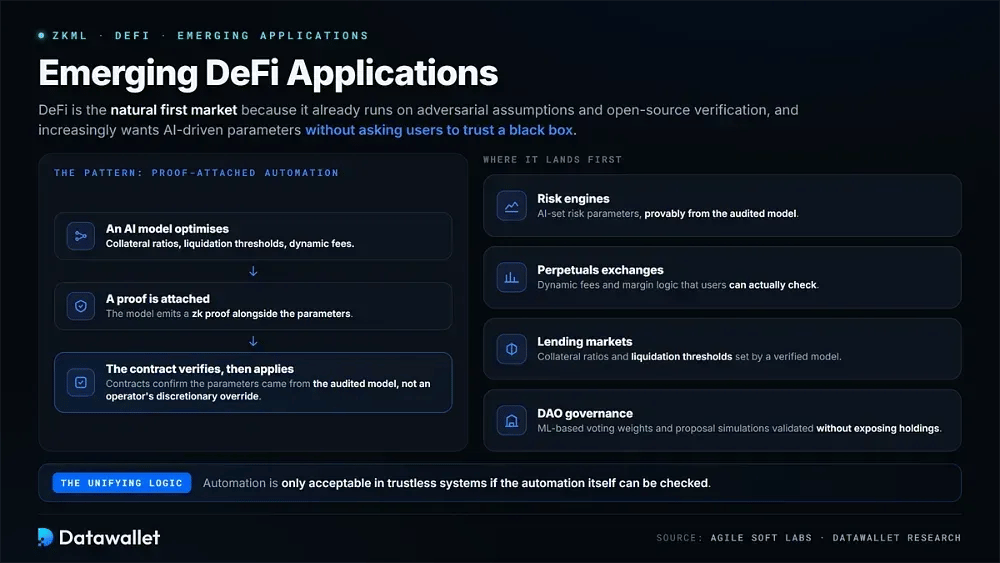
Dezentrale Finanzen sind der naheliegende erste Markt, da sie bereits auf adversarialen Annahmen und Open-Source-Verifizierung beruhen. Risiko-Engines, Börsen für Perpetuals und Lending-Märkte wollen zunehmend KI-gesteuerte Parameter, ohne dass Nutzer einer Blackbox vertrauen müssen.
Das Muster lautet Automatisierung mit beigefügtem Nachweis. Ein KI-Modell optimiert Besicherungsquoten, Liquidation-Schwellenwerte oder dynamische Gebühren, und der beigefügte Nachweis ermöglicht es den Verträgen des Protokolls zu prüfen, dass die Parameter aus dem geprüften Modell stammen und nicht aus einer willkürlichen Übersteuerung durch einen Betreiber.
DAO-Governance ist ein zweites Grenzgebiet, in dem ML-basierte Stimmgewichte oder Vorschlagssimulationen validiert werden können, ohne einzelne Bestände offenzulegen. Die verbindende Logik lautet, dass Automatisierung in vertrauenslosen Systemen nur akzeptabel ist, wenn die Automatisierung selbst überprüft werden kann.
Der zkML-Markt und wichtige Projekte
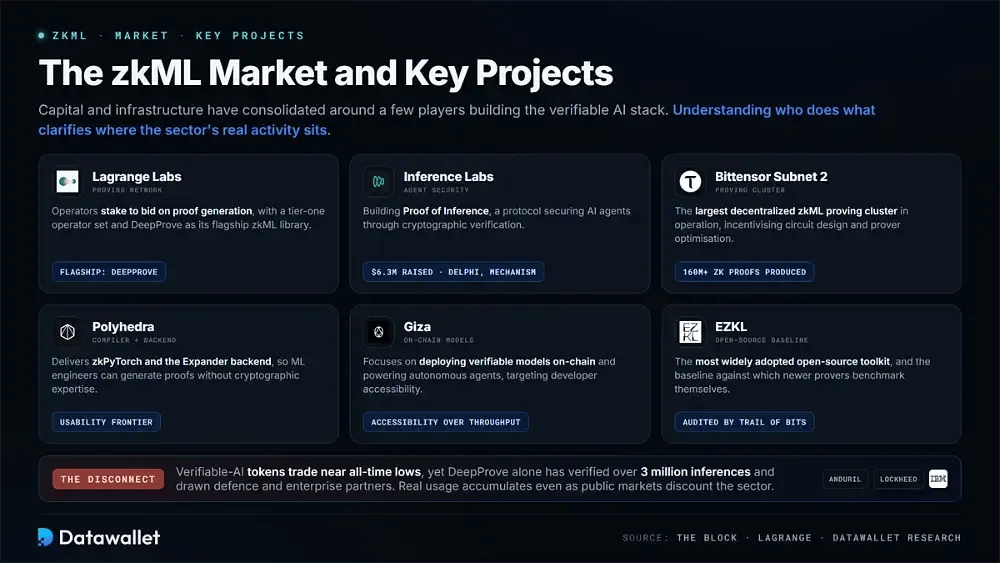
Kapital und Infrastruktur haben sich um einige wenige Akteure konzentriert, die den überprüfbaren KI-Stack aufbauen. Wer was tut, zeigt, wo die tatsächliche Aktivität des Sektors liegt:
- Lagrange Labs: Betreibt ein Proving-Netzwerk, in dem Betreiber Token staken, um auf die Erzeugung von Beweisen zu bieten, mit einem erstklassigen Betreiber-Set und DeepProve als zentraler zkML-Bibliothek für KI-Inferenz.
- Inference Labs: Hat 6,3 Millionen Dollar eingesammelt von Investoren wie Delphi und Mechanism, um Proof of Inference zu entwickeln, ein Protokoll, das KI-Agenten durch kryptografische Verifizierung absichert.
- Bittensor Subnet 2: Der größte dezentrale zkML-Proving-Cluster im Betrieb, der über 160 Millionen zero-knowledge-Beweise erzeugt hat und dabei Schaltkreisdesign und Prover-Optimierung incentiviert.
- Polyhedra: Liefert den zkPyTorch-Compiler und das Expander-Proving-Backend und erweitert die Grenzen der Benutzerfreundlichkeit, sodass ML-Ingenieure Beweise ohne kryptografisches Fachwissen erzeugen können.
- Giza: Konzentriert sich auf die Bereitstellung überprüfbarer Modelle on-chain und den Betrieb autonomer Agenten und setzt dabei auf Zugänglichkeit für Entwickler statt auf reinen Proving-Durchsatz.
- EZKL: Bietet das am weitesten verbreitete Open-Source-Toolkit, das von Trail of Bits geprüft wurde, und dient als Maßstab, an dem sich neuere Prover messen.
Das kommerzielle Bild ist gemischter, als Bullen wie Bären zugeben. Die Preise von Token für verifizierbare KI haben stark gelitten, und mehrere notieren nahe ihrer Allzeittiefs. Dennoch hat allein DeepProve über drei Millionen Inferenzen verifiziert und Partner aus Verteidigung und Wirtschaft wie Anduril, Lockheed Martin und IBM gewonnen. Die reale Nutzung wächst also, auch wenn die öffentlichen Märkte den Sektor abschlagen.
Regulierung und der Compliance-Fall für zkML
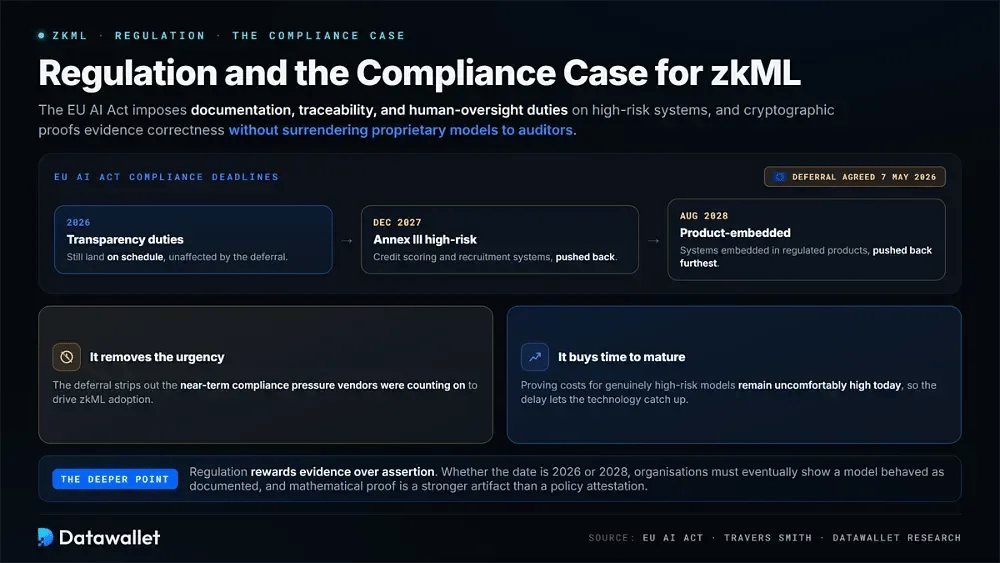
Regulatorischer Druck ist das stärkste Argument außerhalb der Kryptowelt für überprüfbare KI. Der EU AI Act auferlegt Hochrisikosystemen Pflichten zu Dokumentation, Rückverfolgbarkeit und menschlicher Aufsicht, und kryptografische Beweise bieten eine Möglichkeit, die Korrektheit nachzuweisen, ohne proprietäre Modelle gegenüber Prüfern offenzulegen.
Der Zeitplan hat sich 2026 wesentlich verschoben. EU-Gesetzgeber erzielten am 7. Mai 2026 eine politische Einigung, die schwerwiegendsten Pflichten für Hochrisiko-Systeme zu verschieben: Systeme nach Anhang III wie Kreditscoring und Recruiting auf Dezember 2027 und in Produkte eingebettete Systeme auf August 2028, während die Transparenzpflichten weiterhin 2026 greifen.
Diese Verschiebung wirkt für zkML in beide Richtungen. Sie nimmt den kurzfristigen Compliance-Druck, auf den die Anbieter gesetzt hatten, nimmt der Technologie aber zugleich Zeit, vor Ablauf der Fristen zu reifen, denn die Kosten für den Nachweis bei wirklich hochriskanten Modellen sind heute noch unangenehm hoch.
Der tiefere Punkt ist, dass Regulierung Belege über bloße Behauptungen stellt. Ob der Stichtag für die Durchsetzung 2026 oder 2028 ist: Organisationen werden irgendwann nachweisen müssen, dass sich ein eingesetztes Modell wie dokumentiert verhalten hat, und ein mathematischer Beweis ist ein stärkerer Nachweis als eine Richtlinienbestätigung.
zkML, digitale Identität und die Welle der Altersverifizierung
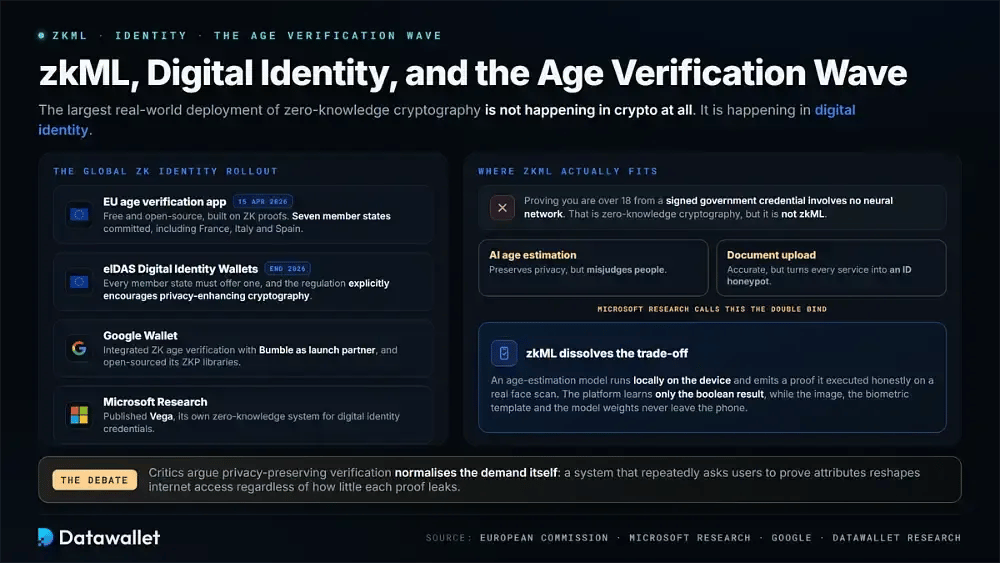
Der größte praktische Einsatz von zero-knowledge-Kryptografie findet gar nicht im Kryptobereich statt. Er findet bei der digitalen Identität statt, getrieben von Vorgaben zur Altersverifizierung, die in Europa, im Vereinigten Königreich und darüber hinaus eingeführt werden.
Das ist für zkML wichtig, weil es die Credential-Infrastruktur, die Wallet-Infrastruktur und die öffentliche Vertrautheit aufbaut, von der verifizierbare KI letztlich abhängen wird, auch wenn die beiden Technologien unterschiedliche Probleme lösen.
Die weltweite Einführung der ZK-Identität
Die Europäische Kommission hat am 15. April 2026 eine kostenlose Open-Source-App zur Altersverifizierung gestartet, die auf Zero-Knowledge-Proof-Kryptografie basiert, sodass Nutzer nachweisen können, dass sie eine Altersgrenze erreichen, ohne ihr Geburtsdatum oder ihre Identität preiszugeben. Sieben Mitgliedstaaten, darunter Frankreich, Italien und Spanien, haben sich zur Integration verpflichtet.
Die Infrastruktur dahinter ist noch größer. Die überarbeitete eIDAS-Verordnung verpflichtet jeden EU-Mitgliedstaat, bis Ende 2026 eine Digital Identity Wallet anzubieten, und fördert ausdrücklich datenschutzfördernde Kryptografie, während der Online Safety Act des Vereinigten Königreichs und der Digital Services Act den Durchsetzungsdruck erzeugen, der die Einführung unumgänglich macht.
Die Privatwirtschaft zog parallel nach. Google integrierte die ZK-Altersverifizierung in Google Wallet, mit Bumble als Launch-Partner, und stellte seine ZKP-Bibliotheken als Open Source bereit, während Microsoft Research mit Vega ein eigenes zero-knowledge-System für digitale Identitätsnachweise veröffentlichte.
Wo zkML tatsächlich passt
Eine wichtige Unterscheidung sollte deutlich benannt werden, da sie häufig verwischt wird. Der Nachweis, dass Sie über achtzehn sind, anhand eines signierten staatlichen Nachweises kommt ohne neuronales Netz aus. Es handelt sich also um zero-knowledge-Kryptografie, aber nicht um zkML. Beide teilen die Mathematik, nicht die Technik.
Die echte Überschneidung liegt bei der Altersschätzung. Plattformen, die Verifizierungspflichten erfüllen müssen, haben die Wahl zwischen KI-basierter Schätzung, die die Privatsphäre wahrt, aber Menschen falsch einschätzt, und dem Hochladen von Dokumenten, das genau ist, aber jeden Dienst zu einem Honeypot für staatliche Ausweisdaten macht. Microsoft Research nennt dies das Double Bind.
zkML löst diesen Zielkonflikt auf. Ein Modell zur Altersschätzung kann lokal auf dem Gerät des Nutzers laufen und einen Beweis erzeugen, dass das offengelegte Modell einen echten Gesichtsscan korrekt verarbeitet hat. So erfährt die Plattform nur das boolesche Ergebnis, während das Bild, die biometrische Vorlage und die Modellgewichte das Smartphone nie verlassen.
Chat Control und die Überwachungsdebatte
Dieselbe Kryptografie steht auch in einem Spannungsverhältnis zu den umstrittenen Chat-Control-Vorschlägen Europas, bei denen die verpflichtende Durchsuchung privater Nachrichten mit dem Kinderschutz begründet wurde. Client-seitiges Scannen und zkML versprechen beide Verifizierung ohne umfassende Offenlegung von Daten, was die Argumentation politisch brisant macht.
Kritiker dieser Regelwerke argumentieren, dass datenschutzfreundliche Verifizierung die Forderung selbst normalisiert, da ein System, das Nutzer wiederholt auffordert, Eigenschaften nachzuweisen, den Internetzugang verändert, unabhängig davon, wie wenige Daten jeder einzelne Nachweis preisgibt. Digitale Bürgerrechtsgruppen haben sich genau aus diesem Grund gegen die Kopplung von Altersprüfungen an Identitäts-Wallets gewandt.
Für zkML ist die Lehre unbequem, aber nützlich. Kryptografische Überprüfbarkeit ist ein wirklich mächtiges Datenschutzinstrument, ermöglicht aber ebenso Compliance-Regime, und die politische Bedeutung der Technologie hängt ganz davon ab, wofür Institutionen einen Nachweis verlangen.
zkML im Vergleich zu anderen verifizierbaren KI-Ansätzen
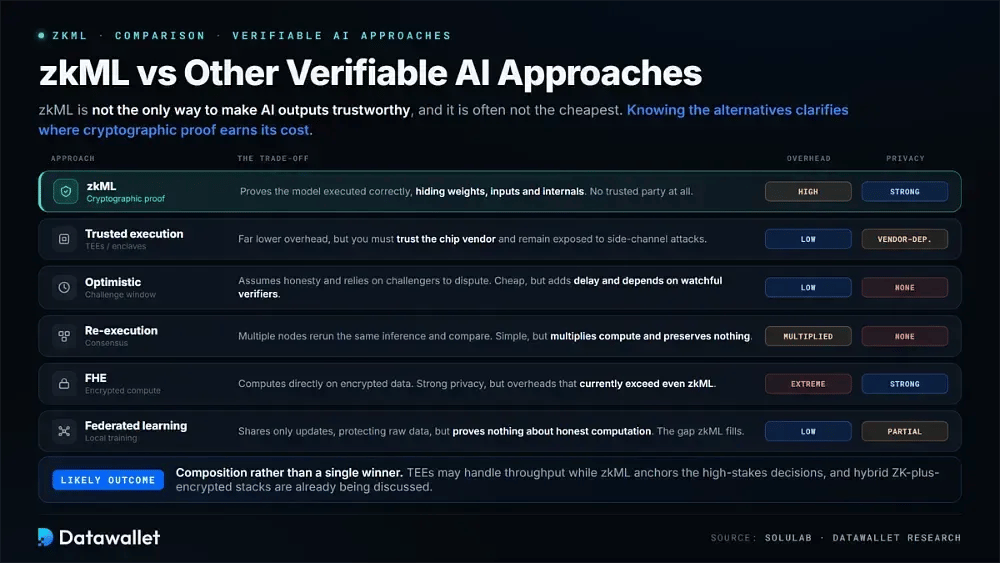
zkML ist nicht der einzige Weg, KI-Ergebnisse vertrauenswürdig zu machen, und oft ist es nicht der günstigste. Ein Blick auf die Alternativen zeigt, wo sich kryptografische Beweise tatsächlich lohnen:
- Trusted Execution Environments: TEEs führen Modelle in sicheren Hardware-Enklaven aus und bestätigen das Ergebnis. Das bedeutet deutlich geringeren Overhead, erfordert aber Vertrauen in den Chiphersteller, und Seitenkanalangriffe bleiben möglich.
- Optimistische Verifizierung: Systeme gehen davon aus, dass Berechnungen ehrlich sind, und verlassen sich darauf, dass Challenger sie innerhalb eines Zeitfensters anfechten. Das ist günstig, führt aber zu Verzögerungen und hängt von aufmerksamen, wirtschaftlich motivierten Verifizierern ab.
- Konsens-Neuausführung: Mehrere Knoten führen dieselbe Inferenz erneut aus und vergleichen die Ergebnisse. Dieser einfache Ansatz vervielfacht die Rechenkosten und kann die Vertraulichkeit von Eingaben oder Gewichten nicht wahren.
- Vollhomomorphe Verschlüsselung: FHE rechnet direkt auf verschlüsselten Daten und bietet starken Datenschutz, verursacht aber Leistungseinbußen, die derzeit bei den meisten Machine-Learning-Workloads sogar zkML übersteigen.
- Federated Learning: Das Training findet lokal statt und es werden nur Updates geteilt. Das schützt die Rohdaten, belegt aber nicht, dass jeder Teilnehmer ehrlich gerechnet hat. Dadurch entsteht eine Integritätslücke, die zkML schließen kann.
Das wahrscheinliche Ergebnis ist eine Kombination statt eines einzelnen Gewinners. Hybride Architekturen, die ZK-Beweise mit verschlüsselter Berechnung verbinden, werden für besonders sensible Cloud-Workloads bereits diskutiert, und TEEs könnten den Durchsatz übernehmen, während zkML die folgenreichen Entscheidungen absichert.
Risiken und Einschränkungen
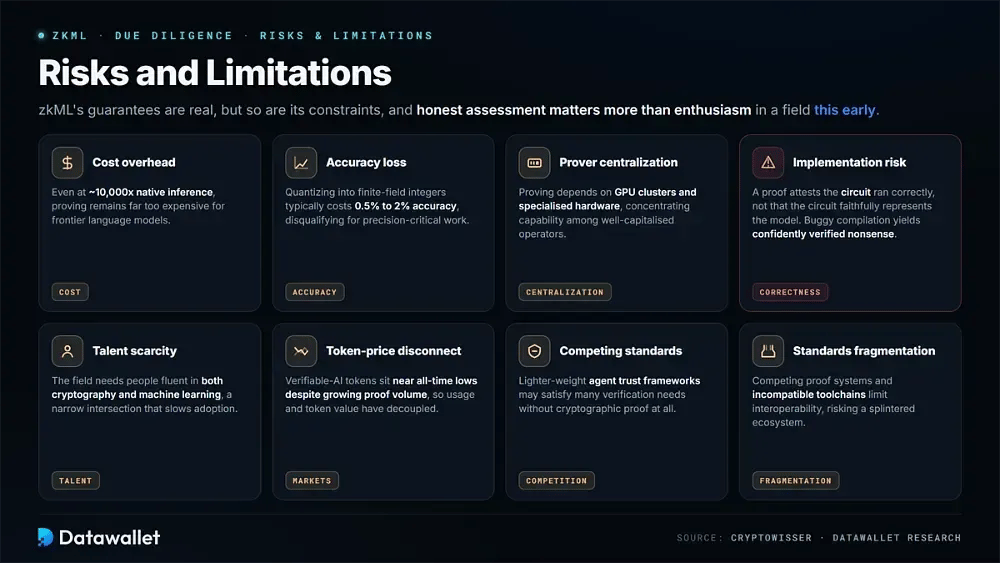
Die Garantien von zkML sind real, ebenso aber seine Einschränkungen, und in einem so frühen Feld ist eine ehrliche Einschätzung wichtiger als Begeisterung. Die wichtigsten Bedenken sind:
- Kostenaufwand: Selbst bei etwa dem 10.000-Fachen der nativen Inferenz bleibt das Beweisen für Frontier-Sprachmodelle viel zu teuer, sodass zkML auf absehbare Zeit auf kleinere, klar definierte Modelle beschränkt bleibt.
- Genauigkeitsverlust: Die Quantisierung von Gleitkommagewichten in Ganzzahlen eines endlichen Körpers kostet typischerweise 0,5 bis 2 % Genauigkeit – ein für viele Aufgaben akzeptabler Kompromiss, der aber für präzisionskritische Anwendungen ausschließt.
- Zentralisierung der Prover: Die Beweiserstellung hängt zunehmend von GPU-Clustern und spezialisierter Hardware ab, wodurch sich die Fähigkeiten bei kapitalstarken Betreibern konzentrieren und die Dezentralisierung untergraben wird, der die Technologie dienen soll.
- Implementierungsrisiko: Ein Beweis bestätigt nur, dass eine Schaltung korrekt ausgeführt wurde, nicht dass sie das beabsichtigte Modell getreu abbildet. Fehlerhafte Kompilierung kann daher mit hoher Sicherheit verifizierten Unsinn erzeugen.
- Fachkräftemangel: Das Feld verlangt Menschen, die sowohl in Kryptografie als auch in maschinellem Lernen sicher sind. Diese schmale Schnittmenge bremst die Einführung in Unternehmen, unabhängig davon, wie gut die zugrunde liegenden Werkzeuge werden.
- Abkopplung des Token-Preises: Token für überprüfbare KI notieren trotz wachsendem Proof-Volumen nahe ihrer Allzeittiefs. Infrastrukturnutzung und Token-Wert haben sich also entkoppelt, und Inhaber können nicht davon ausgehen, dass sich Adoption im Preis niederschlägt.
- Konkurrierende Standards: Leichtgewichtigere Vertrauensframeworks für Agenten könnten viele Verifizierungsanforderungen ohne kryptografischen Beweis erfüllen und Anwendungsfälle abdecken, die zkML für sich erwartet hatte.
- Fragmentierung der Standards: Konkurrierende Beweissysteme und inkompatible Toolchains schränken die Interoperabilität ein. Ohne Konvergenz könnte sich die Akzeptanz auf Ökosysteme aufspalten, die die Arbeit der jeweils anderen nicht verifizieren können.
Fazit
zkML hat den Sprung von der Forschungskuriosität zu funktionierender Infrastruktur geschafft. Eine vollständige GPT-2-Inferenz wurde bewiesen, mittelgroße Bildmodelle werden in Sekunden bewiesen, und der Mehraufwand ist in etwa zwei Jahren um zwei Größenordnungen gesunken, eine schnellere Verbesserungskurve als bei den meisten kryptografischen Primitiven je erreicht wurde.
Die ehrliche Einschränkung besteht darin, dass die Lücke zwischen dem, was beweisbar ist, und dem, was eingesetzt wird, weiterhin groß bleibt. Spitzenmodelle liegen vier Größenordnungen jenseits des wirtschaftlich Machbaren, die Prover-Hardware konzentriert sich bei kapitalstarken Betreibern, und die Token des Sektors notieren weit unter den Erwartungen aus der Finanzierungsphase, obwohl das Beweisvolumen steigt.
Das strategische Argument beruht darauf, wohin sich KI entwickelt, nicht darauf, wo sie heute steht. Autonome Agenten beginnen, reales Kapital zu bewegen, Aufsichtsbehörden verlangen nachweisbares Modellverhalten, und die Zero-Knowledge-Identitätsinfrastrukturen, die derzeit in ganz Europa eingeführt werden, machen kryptografische Beweise unbemerkt zur alltäglichen Infrastruktur. Für alle, die die Konvergenz von KI und Krypto verfolgen, ist zkML die Schicht, in der diese Entwicklungen aufeinandertreffen.